Mit LiteLLM stellt die FH Münster einen zentralen Dienst bereit, über den verschiedene Sprachmodelle genutzt werden können. Der Zugriff erfolgt nicht direkt mit persönlichen Zugangsdaten, sondern über individuelle API-Schlüssel (LiteLLM Keys).
Diese Schlüssel ermöglichen es, die bereitgestellten KI-Modelle einfach und sicher in eigenen Anwendungen, Skripten oder Tools einzubinden. Durch die Verwendung von API-Keys wird die Handhabung für Nutzerinnen und Nutzer erleichtert und gleichzeitig ein sicherer Zugang gewährleistet.
Studierende können Zugang zu LiteLLM per Email an den IT Support (it-support@fh-muenster.de) beantragen.
Alle über LiteLLM verfügbaren Modelle (inkl. Kosten) sind hier abrufbar: https://litellm-models.fh-muenster.de/
Videomodelle werden nicht über Token sondern über Videolänge abgerechnet. Hier geht's zu den Preisen für Google's Veo.
Abonnieren Sie die FHAI-Mailingliste, um über Ankündigungen und Änderungen rund um das KI-Angebot an der FH Münster informiert zu werden.
01. Anfrage eines LiteLLM Schlüssels
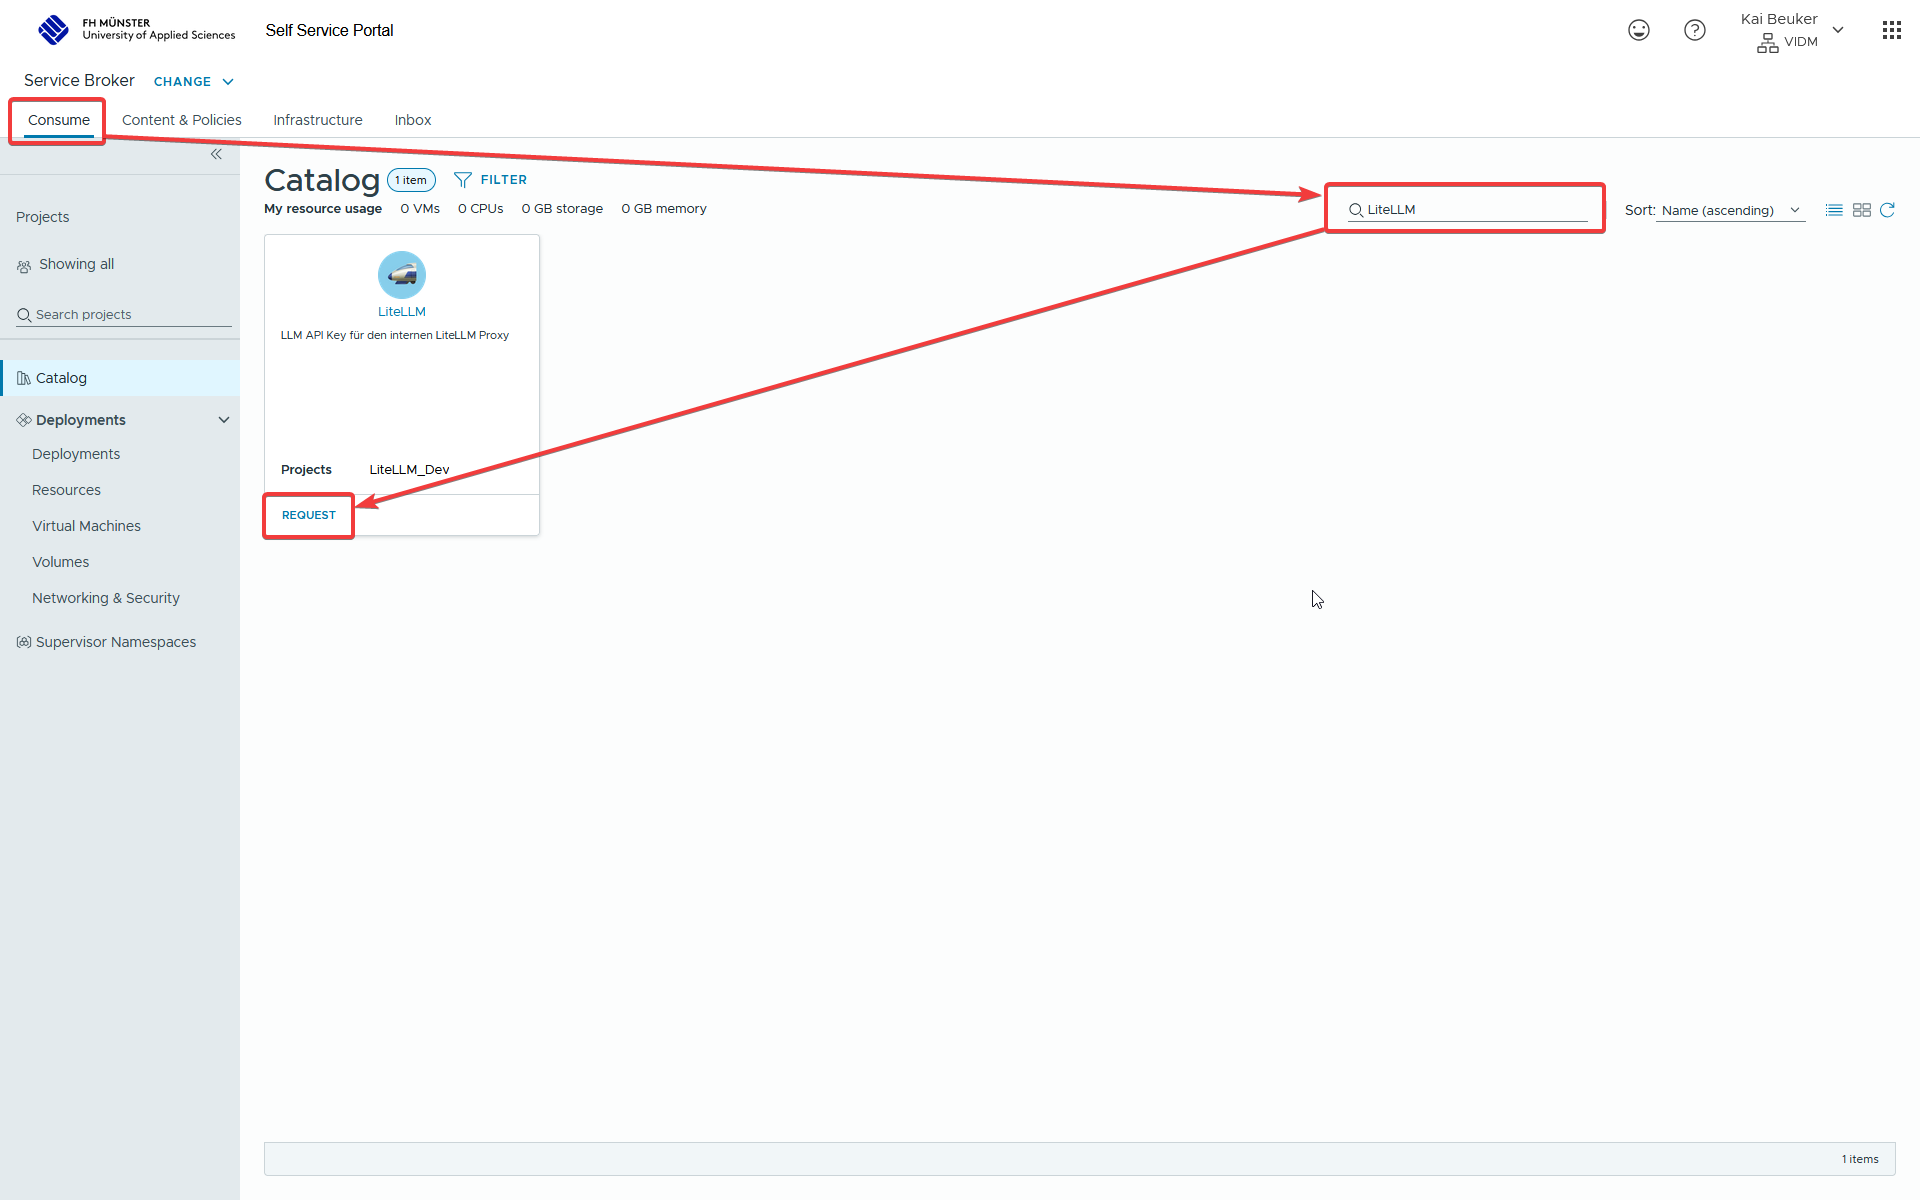
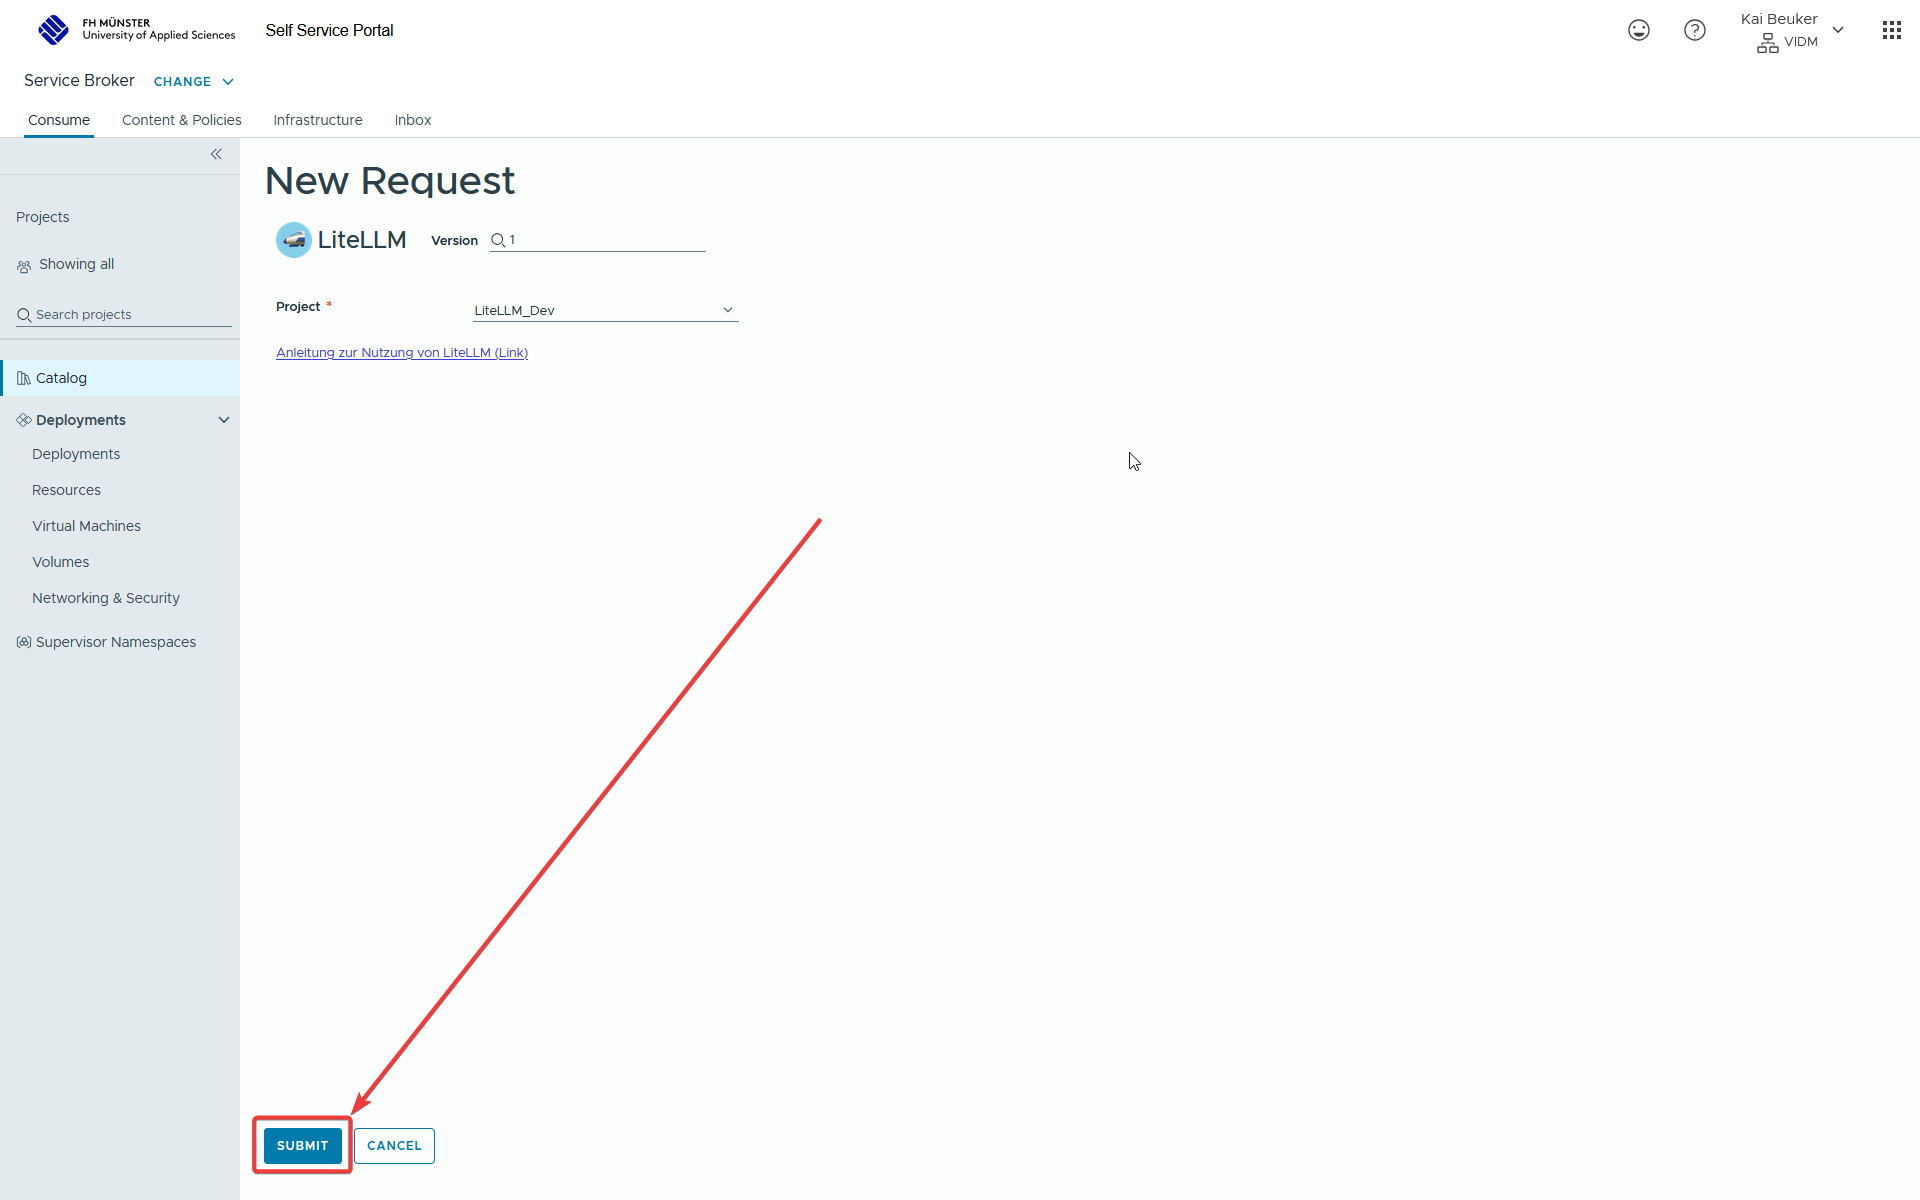
Das Deployment läuft jetzt automatisch. Sie erhalten nach wenigen Sekunden eine Email mit dem generierten Schlüssel. Diesen können Sie jetzt, solange Sie sich im Netz der FH Münster befinden, verwenden. Geben Sie diesen Schlüssel nicht an Andere weiter.
Um Ihre aktuellen Budgetinformationen abzufragen (Maximalbudget und bisheriger Verbrauch) können Sie eine Funktion im vRA benutzen. Aktuell bekommt jeder neue Nutzer ein Budget von 30 USD pro Semester.
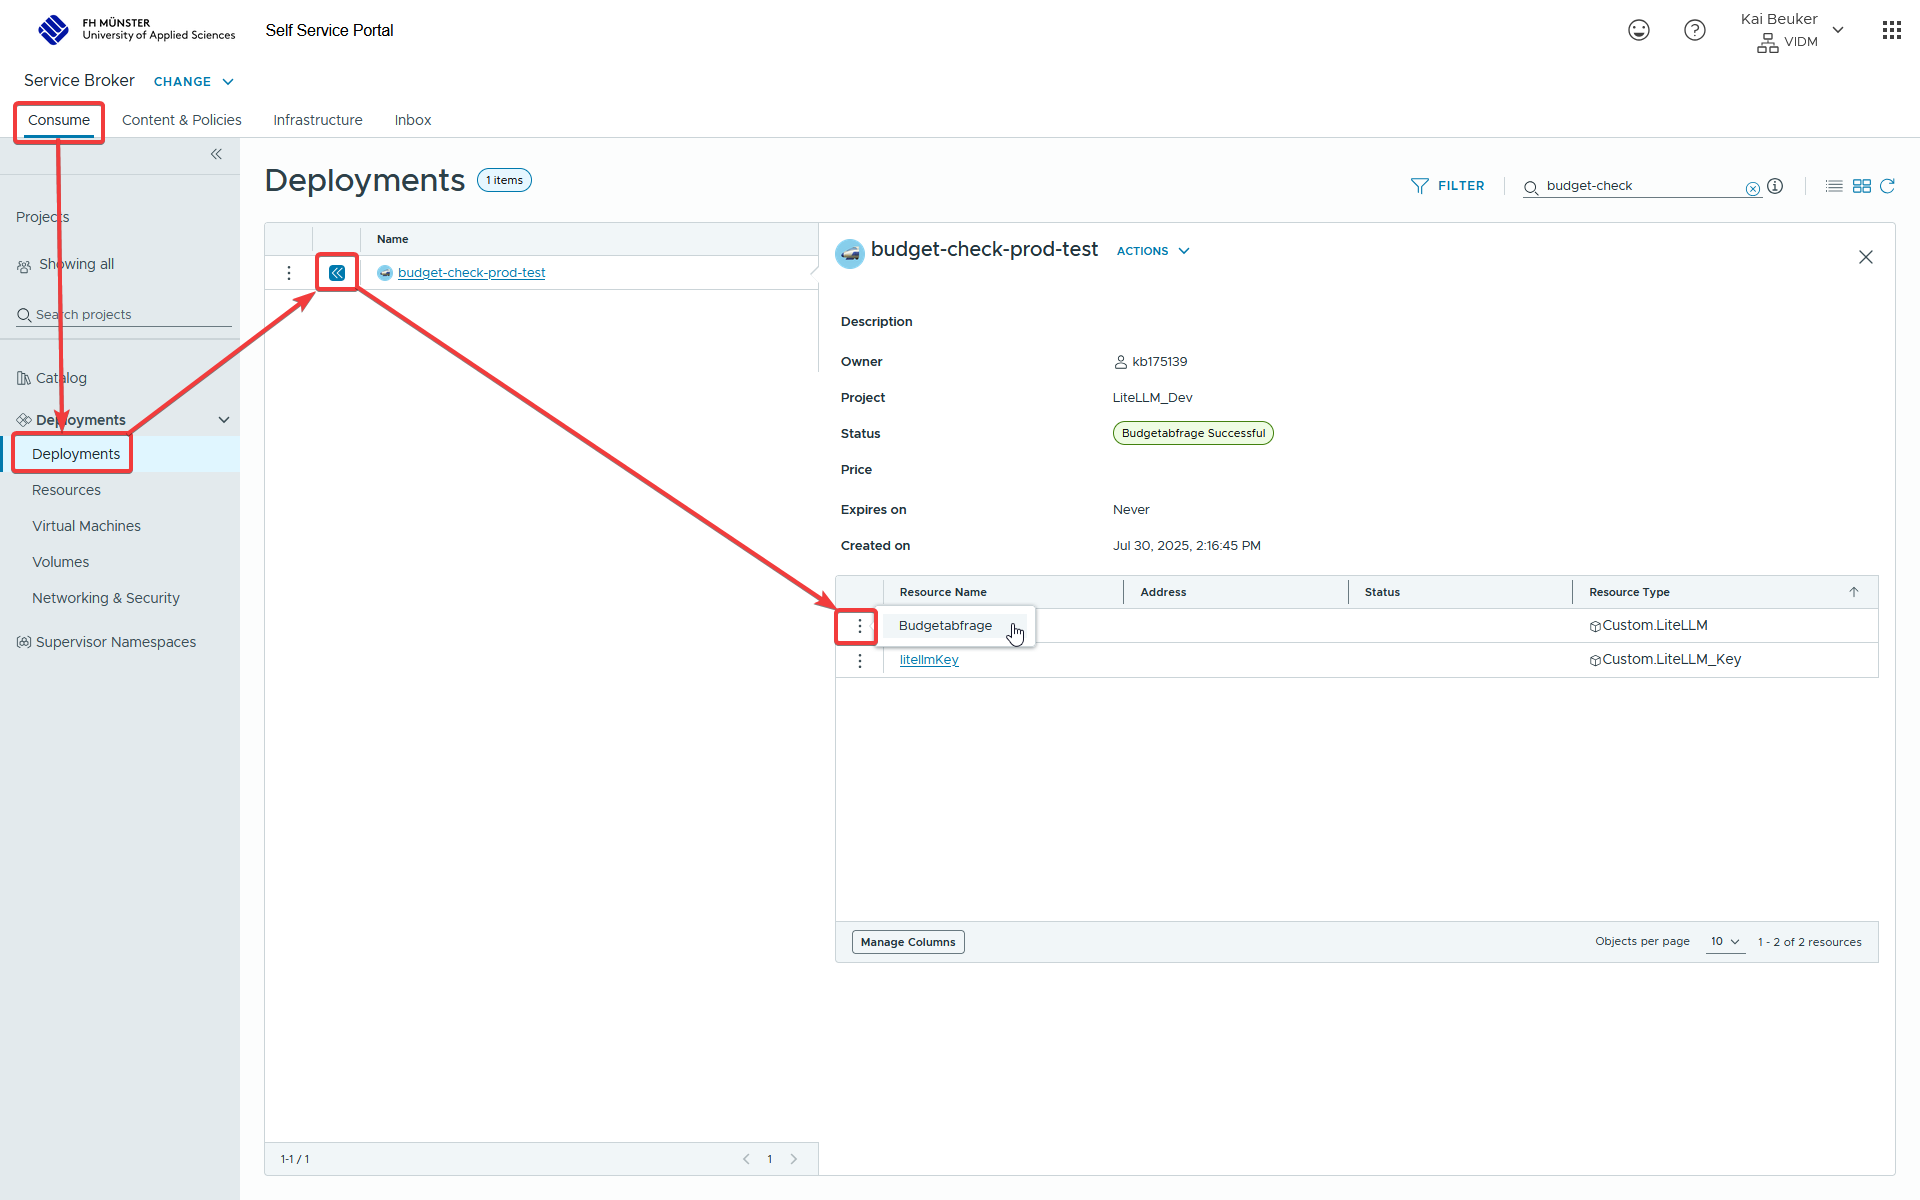
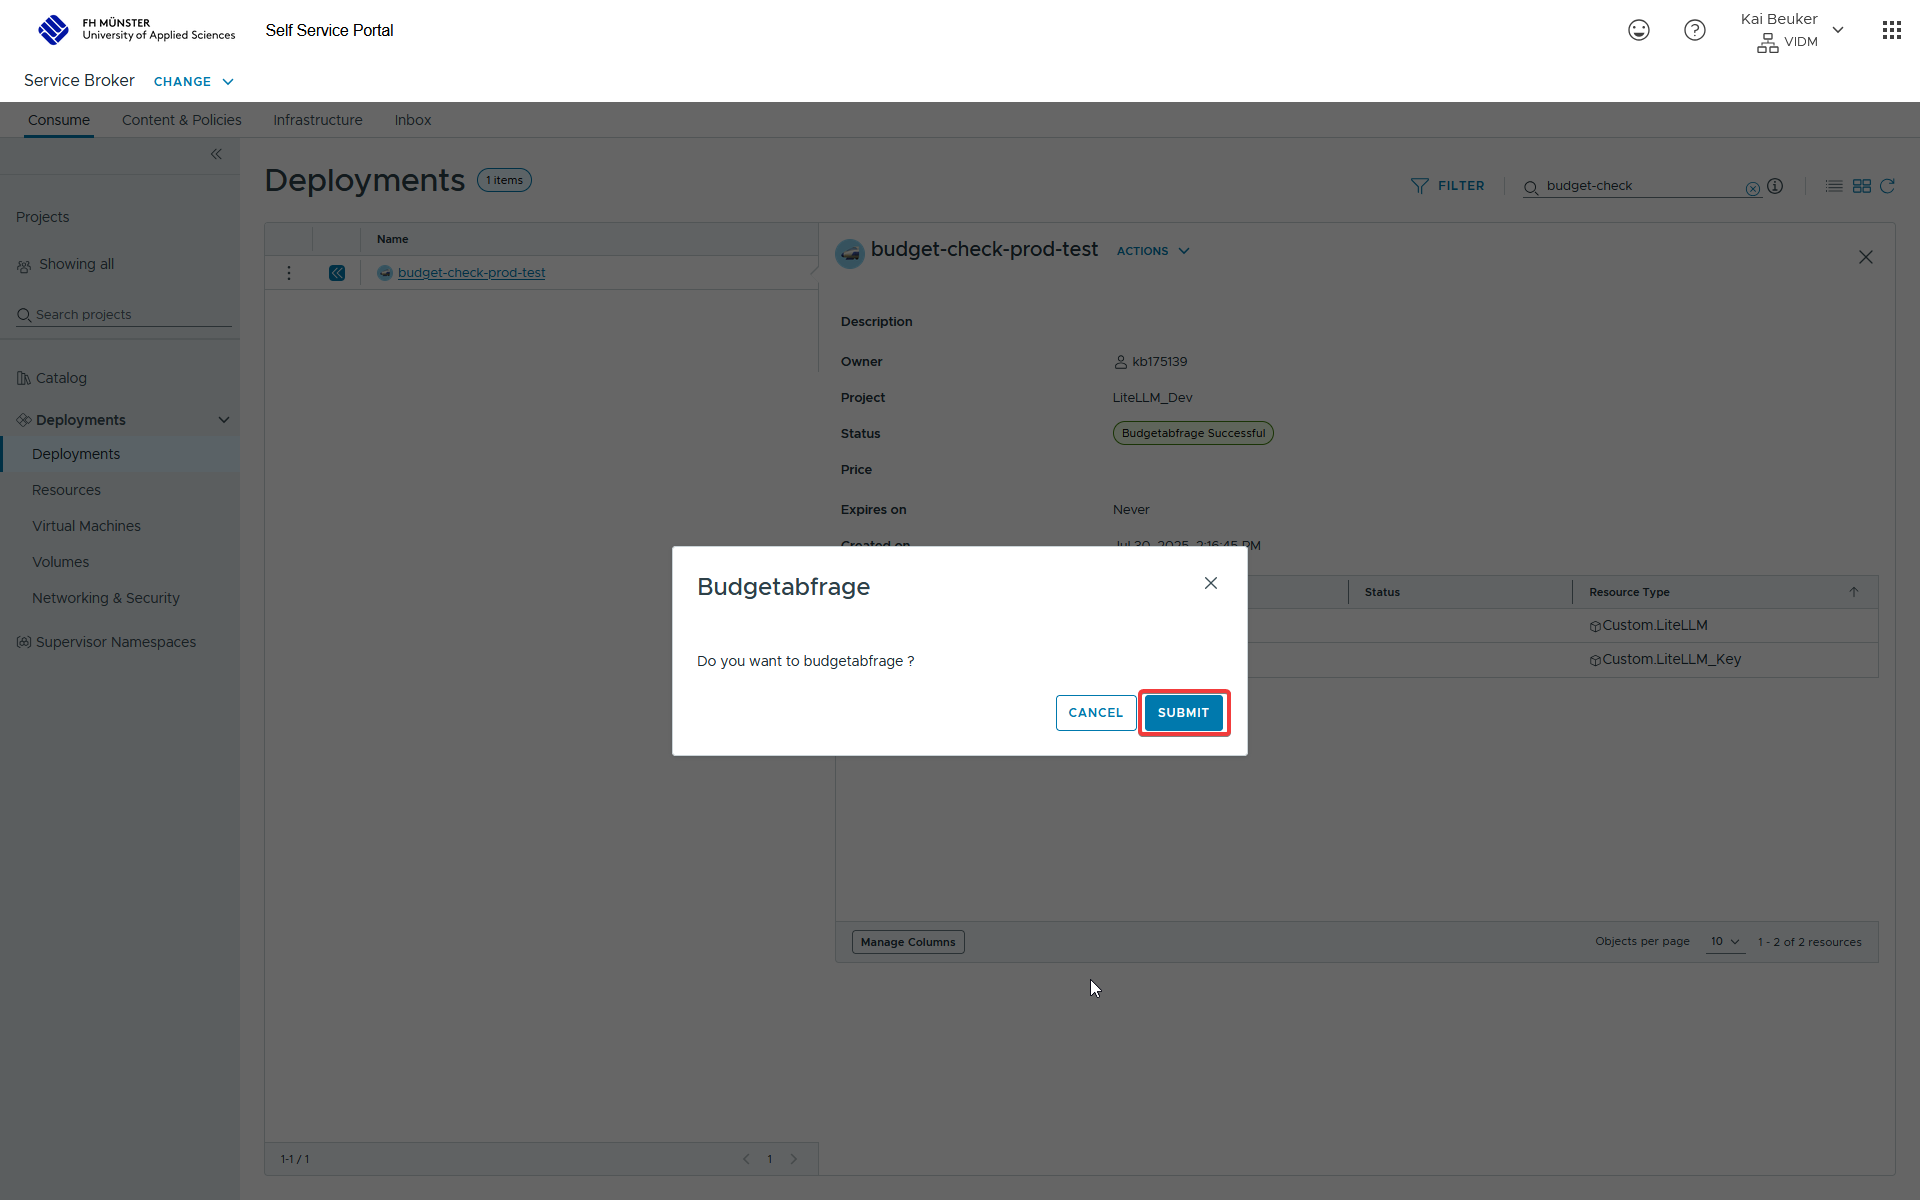
Sie erhalten daraufhin eine Email mit Ihren aktuellen Budgetinformationen.
Falls Ihr Initialbudget erschöpft ist können Sie eine Erweiterung des Budgets beantragen.
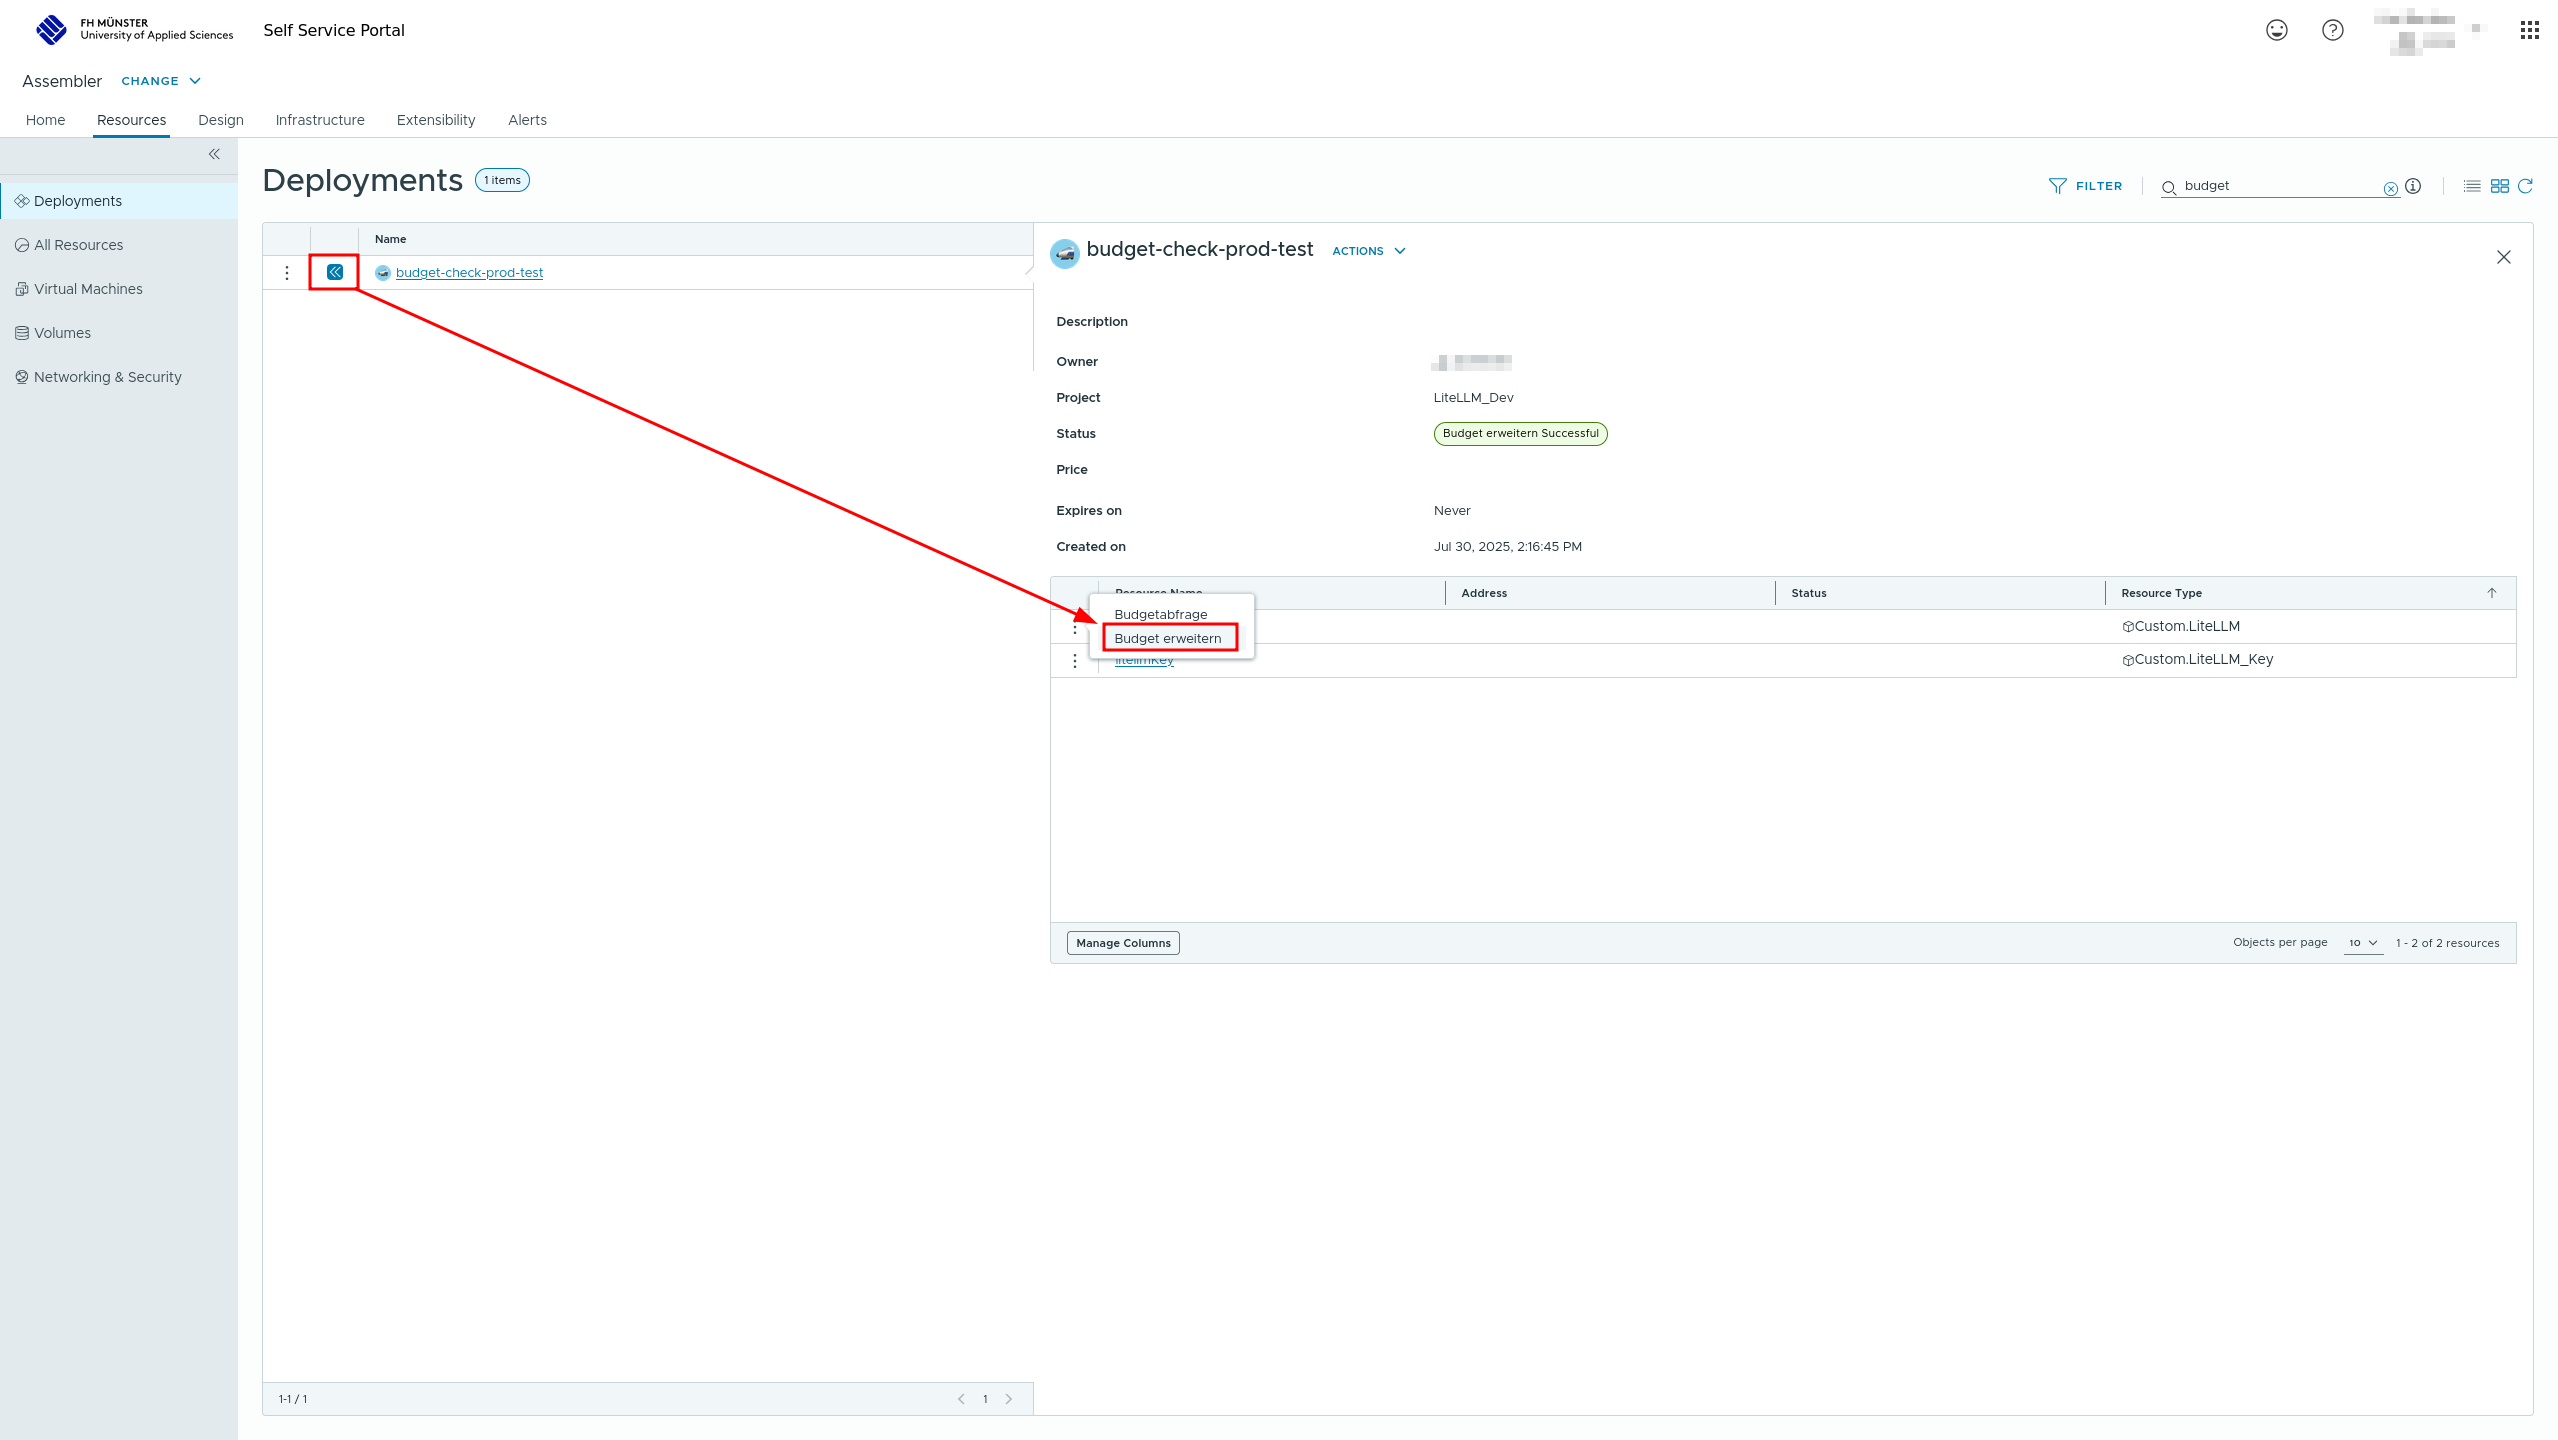
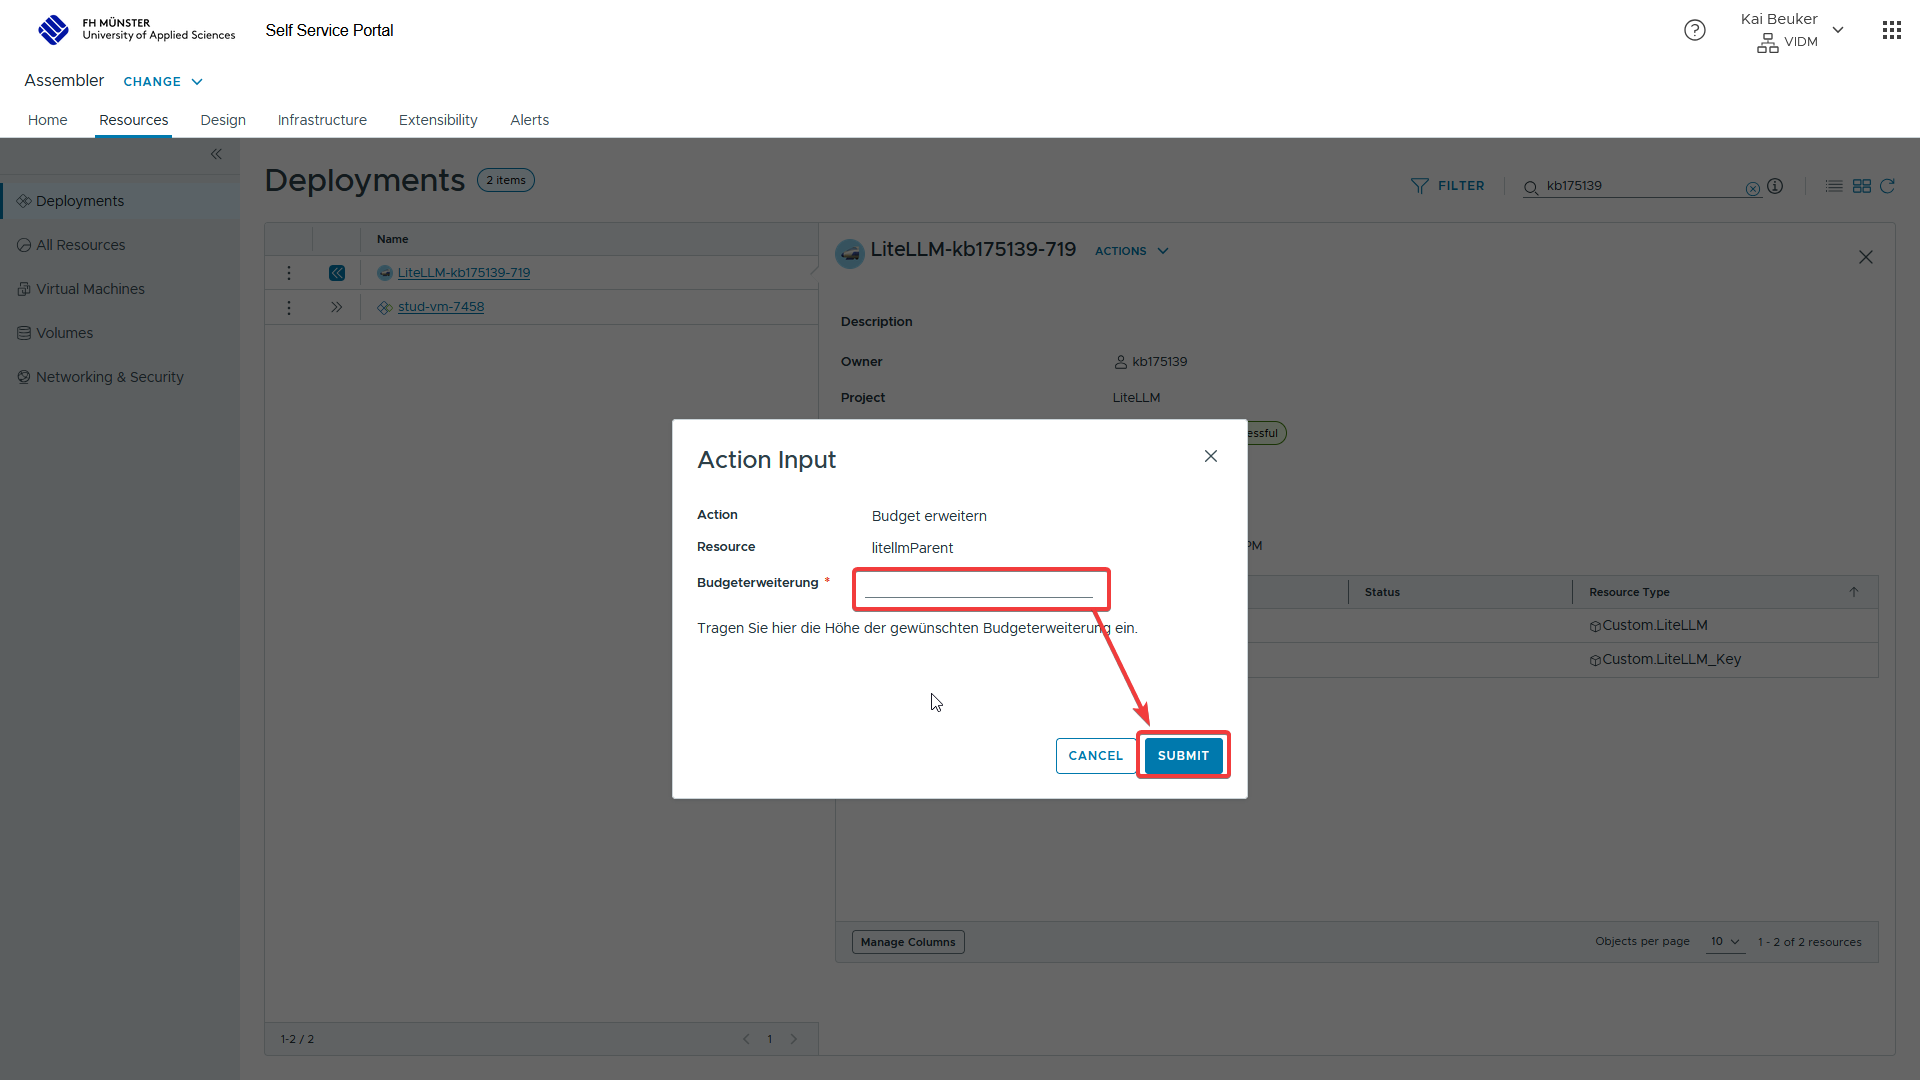
Ihr Antrag wird dann automatisch an die DVZ geschickt. Sobald der Antrag genehmigt wird, wird die Budgeterweiterung automatisch ausgeführt und Sie bekommen eine Benachrichtigung per Email. Sämtliche Budgeterweiterungen werden zur gleichen Zeit wie die Budget-Resets wieder zurückgesetzt.
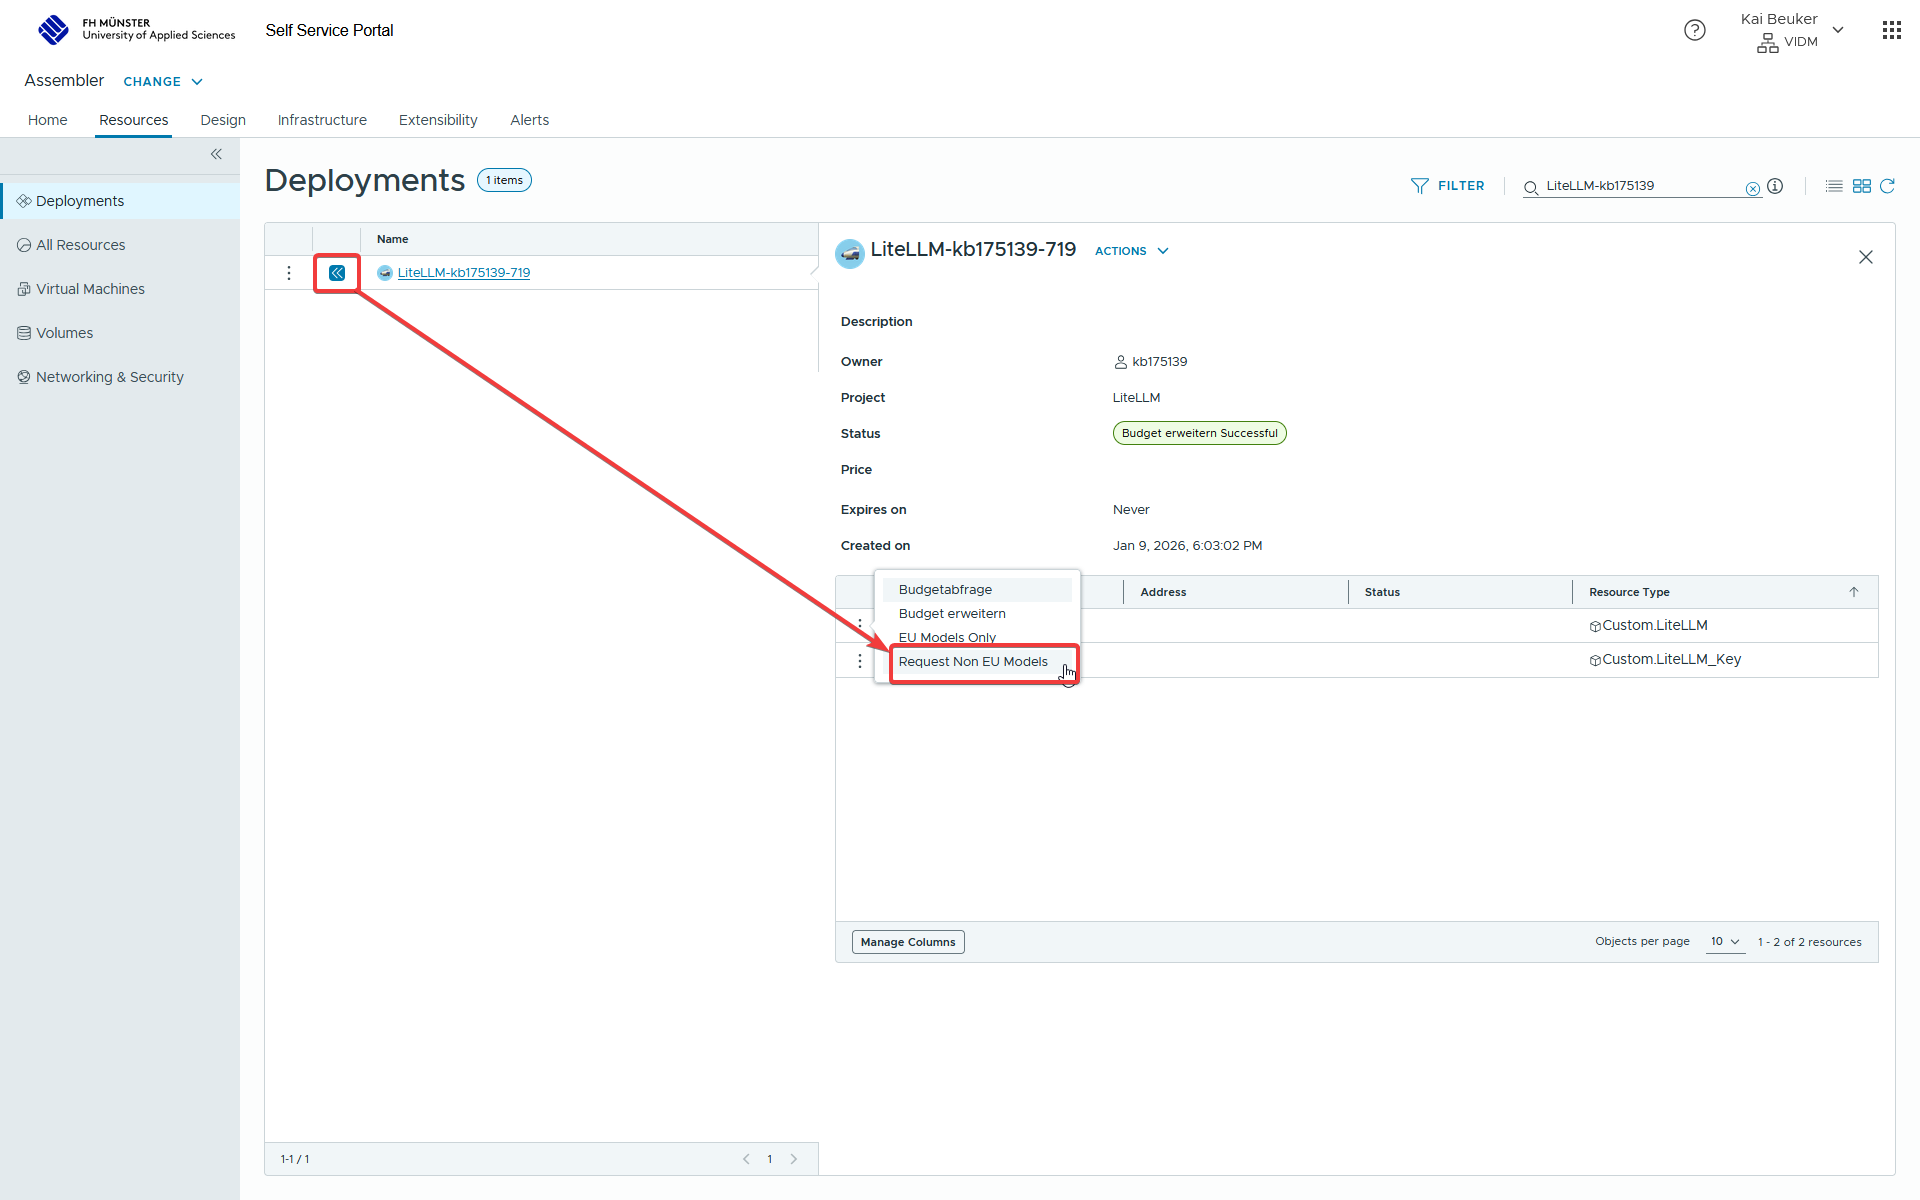
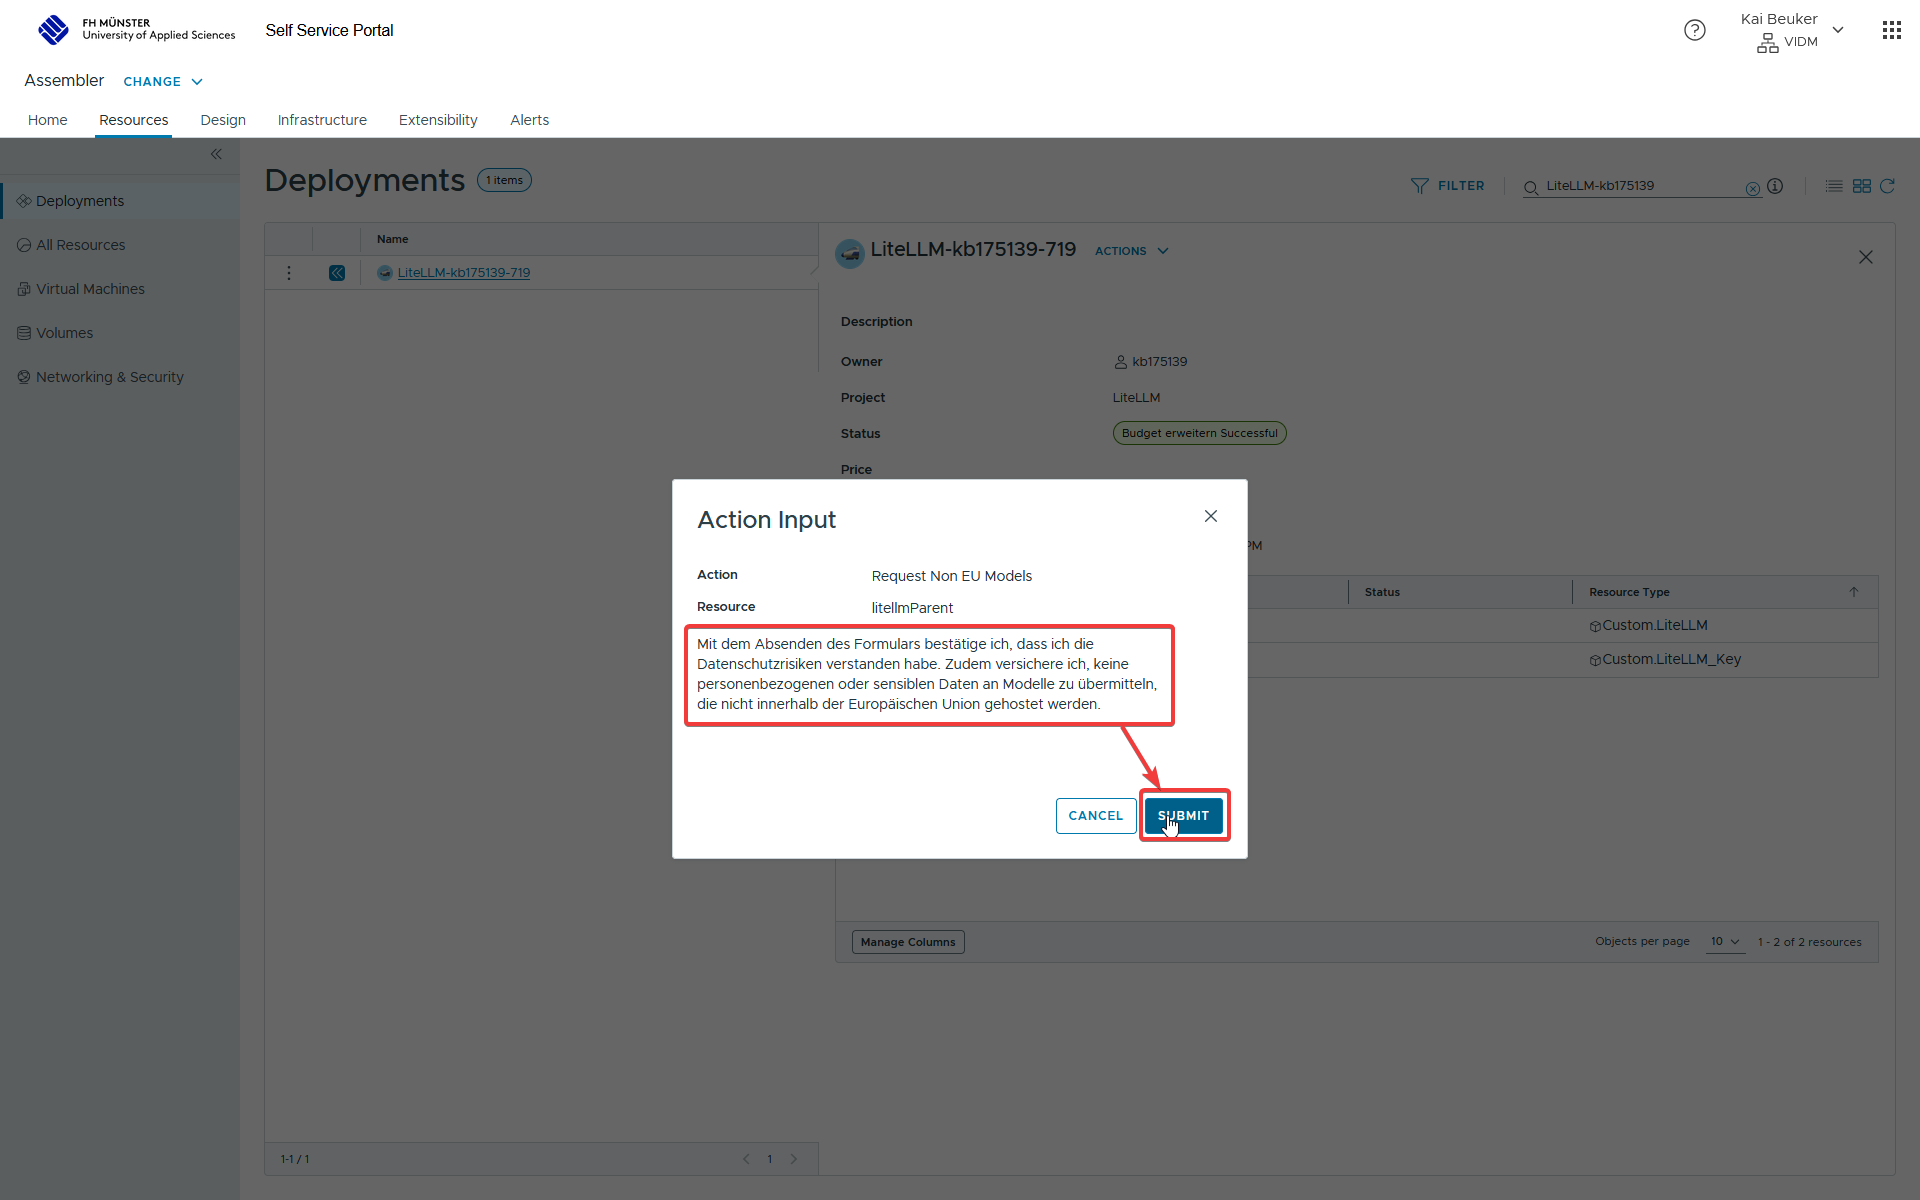
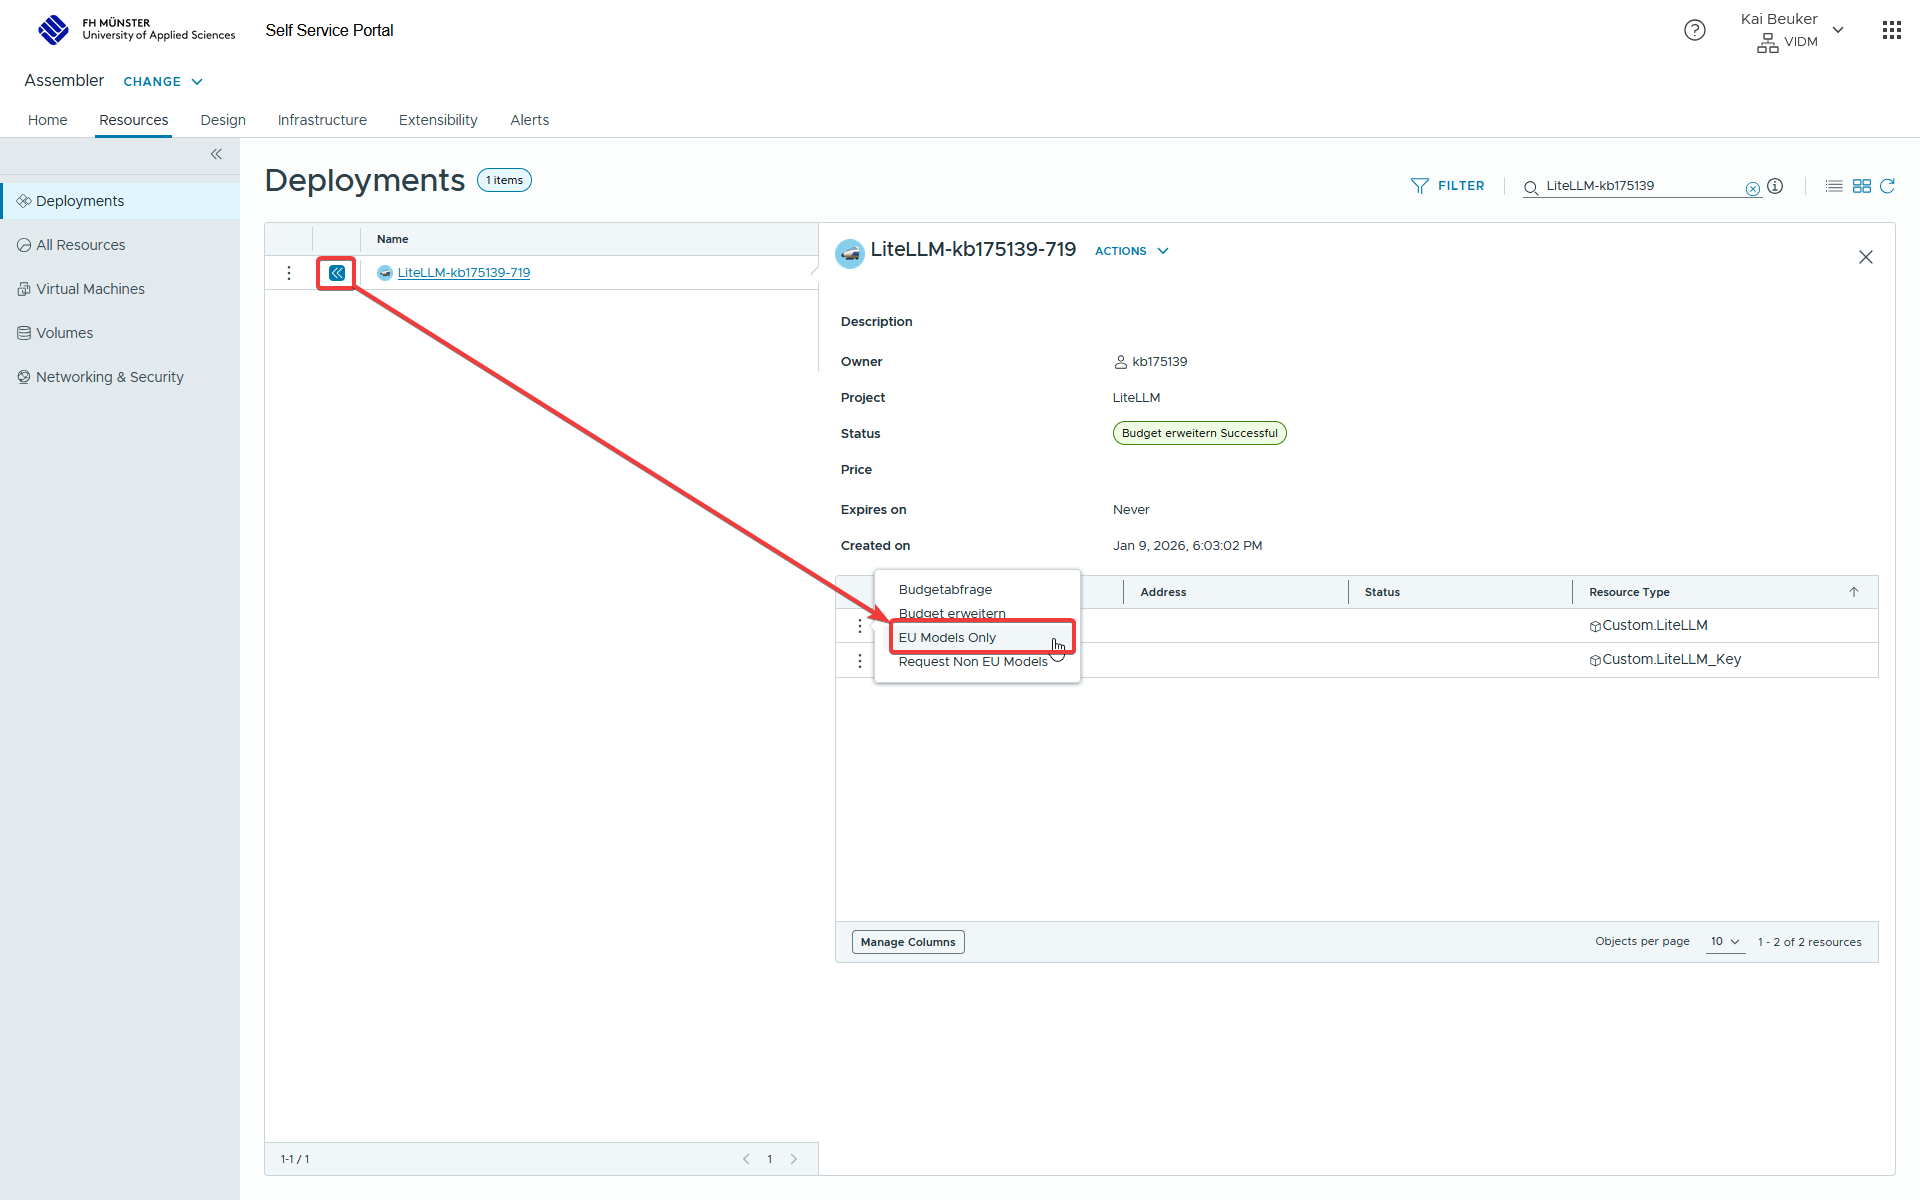
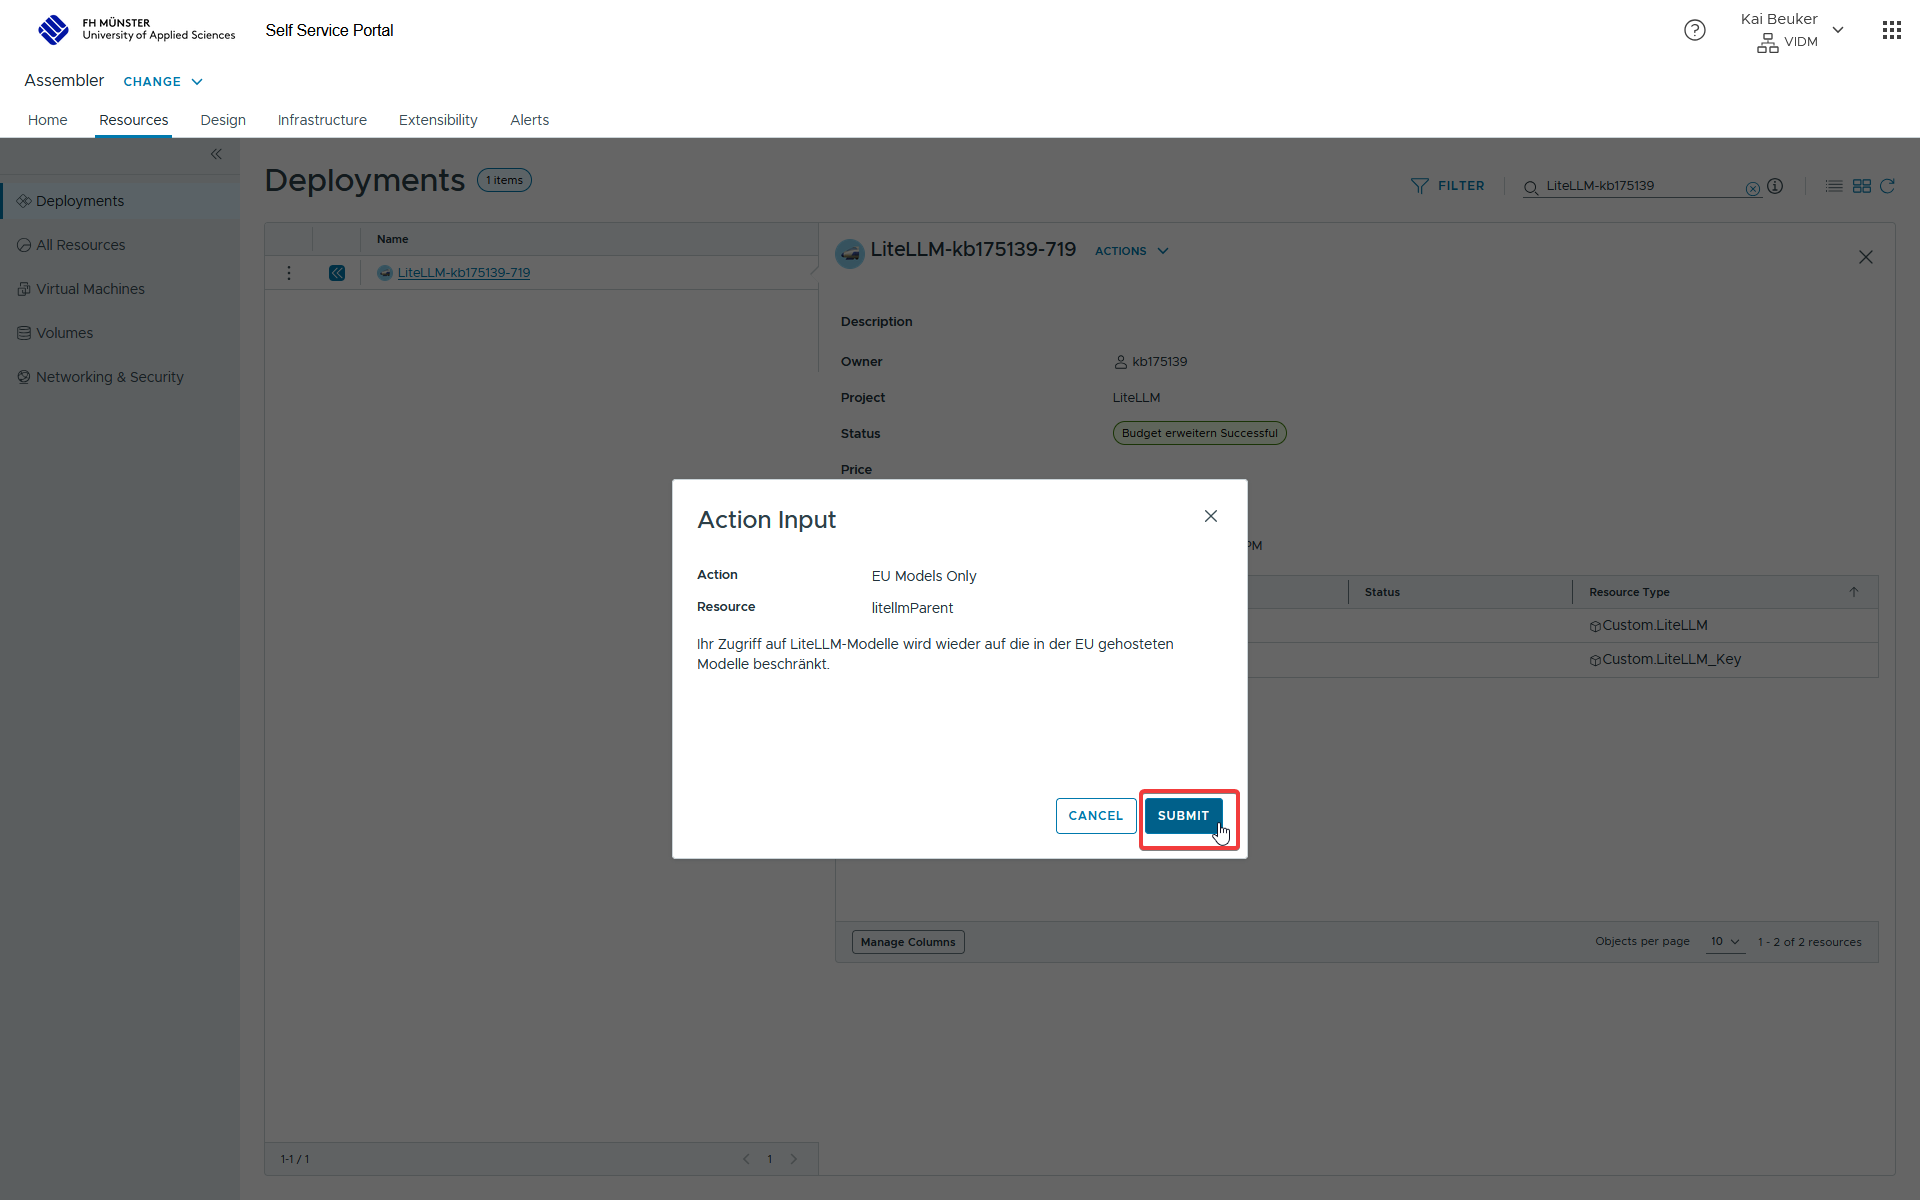
Um Zugriff auf Modelle zu bekommen, die nicht in der EU gehostet werden und damit nicht der Datenschutzgrundverordnung (DSGVO) unterliegen, muss dies erst freigeschaltet werden. Später kann man den Zugriff wieder beschränken.
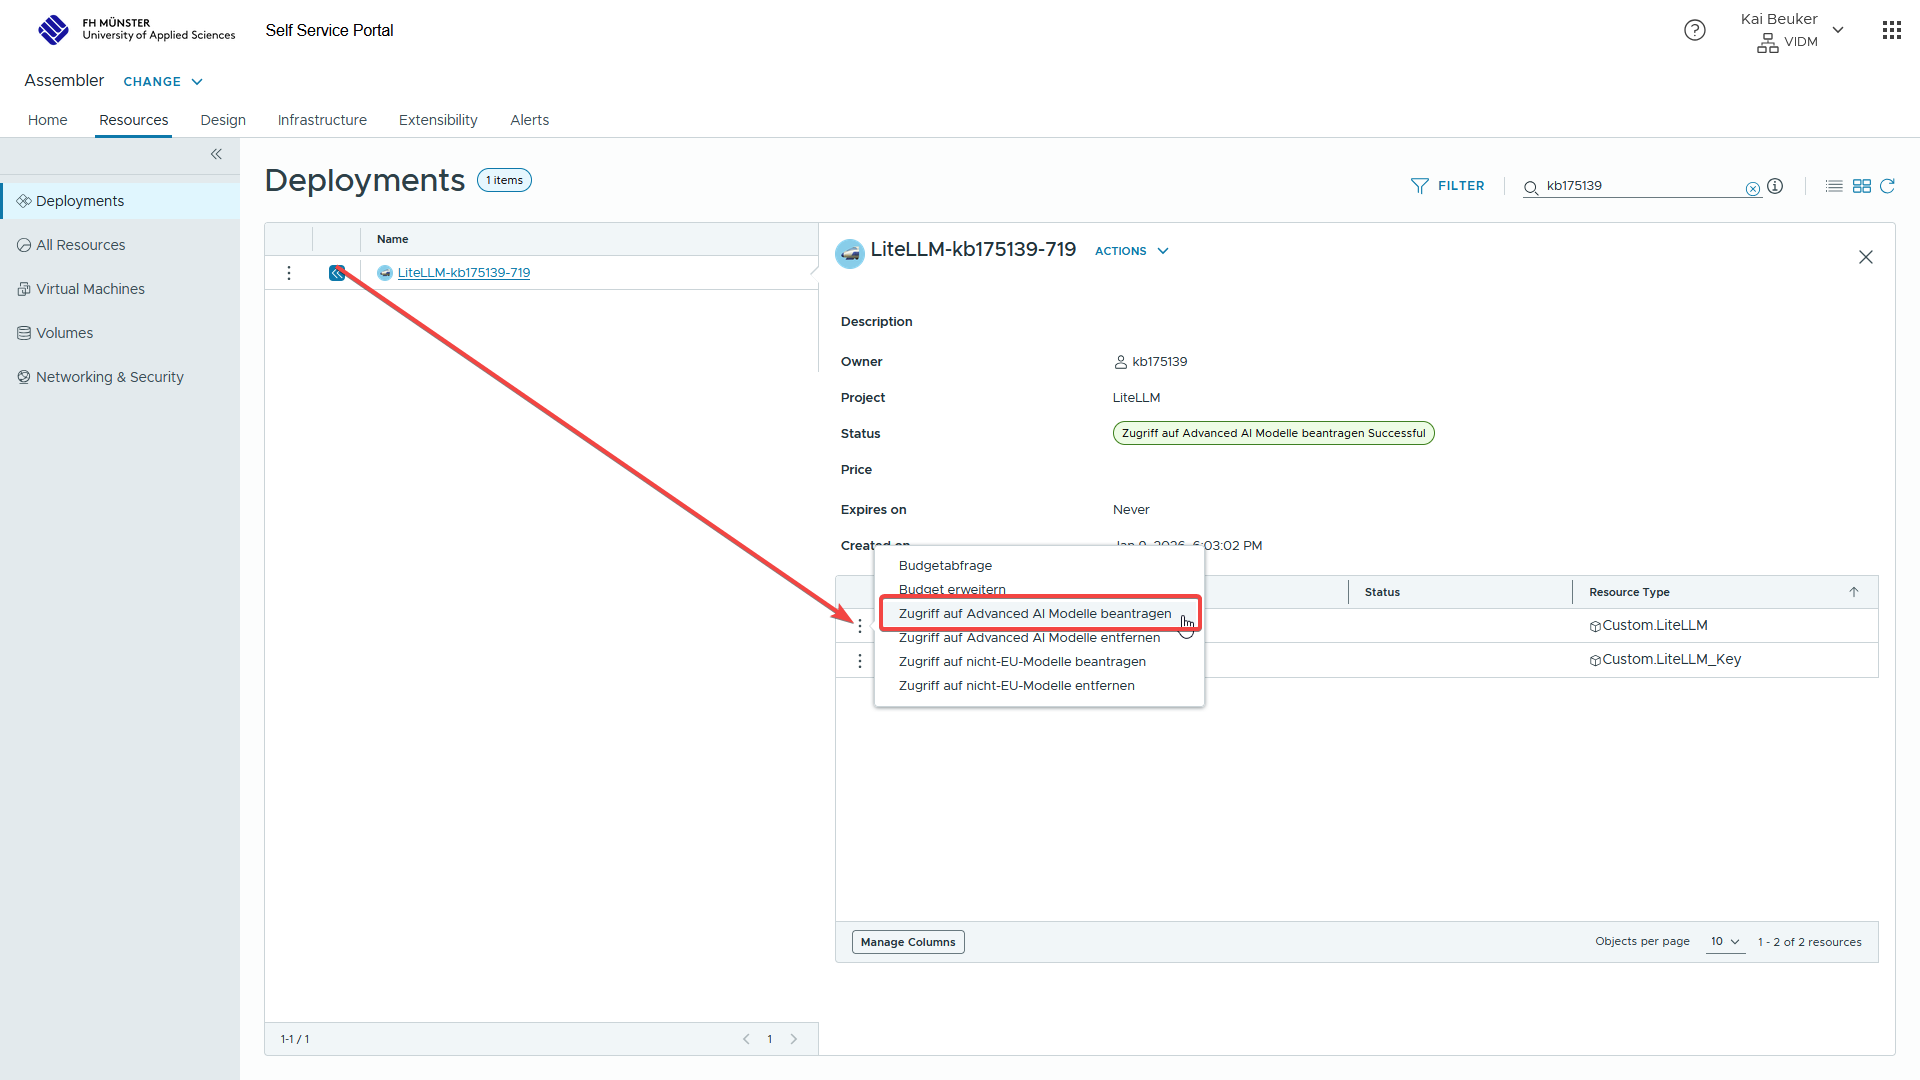
Um Zugriff auf Advanced AI Modelle, wie Claude Fable 5 zu bekommen, muss dies erst freigeschaltet werden. Später kann man den Zugriff wieder beschränken.
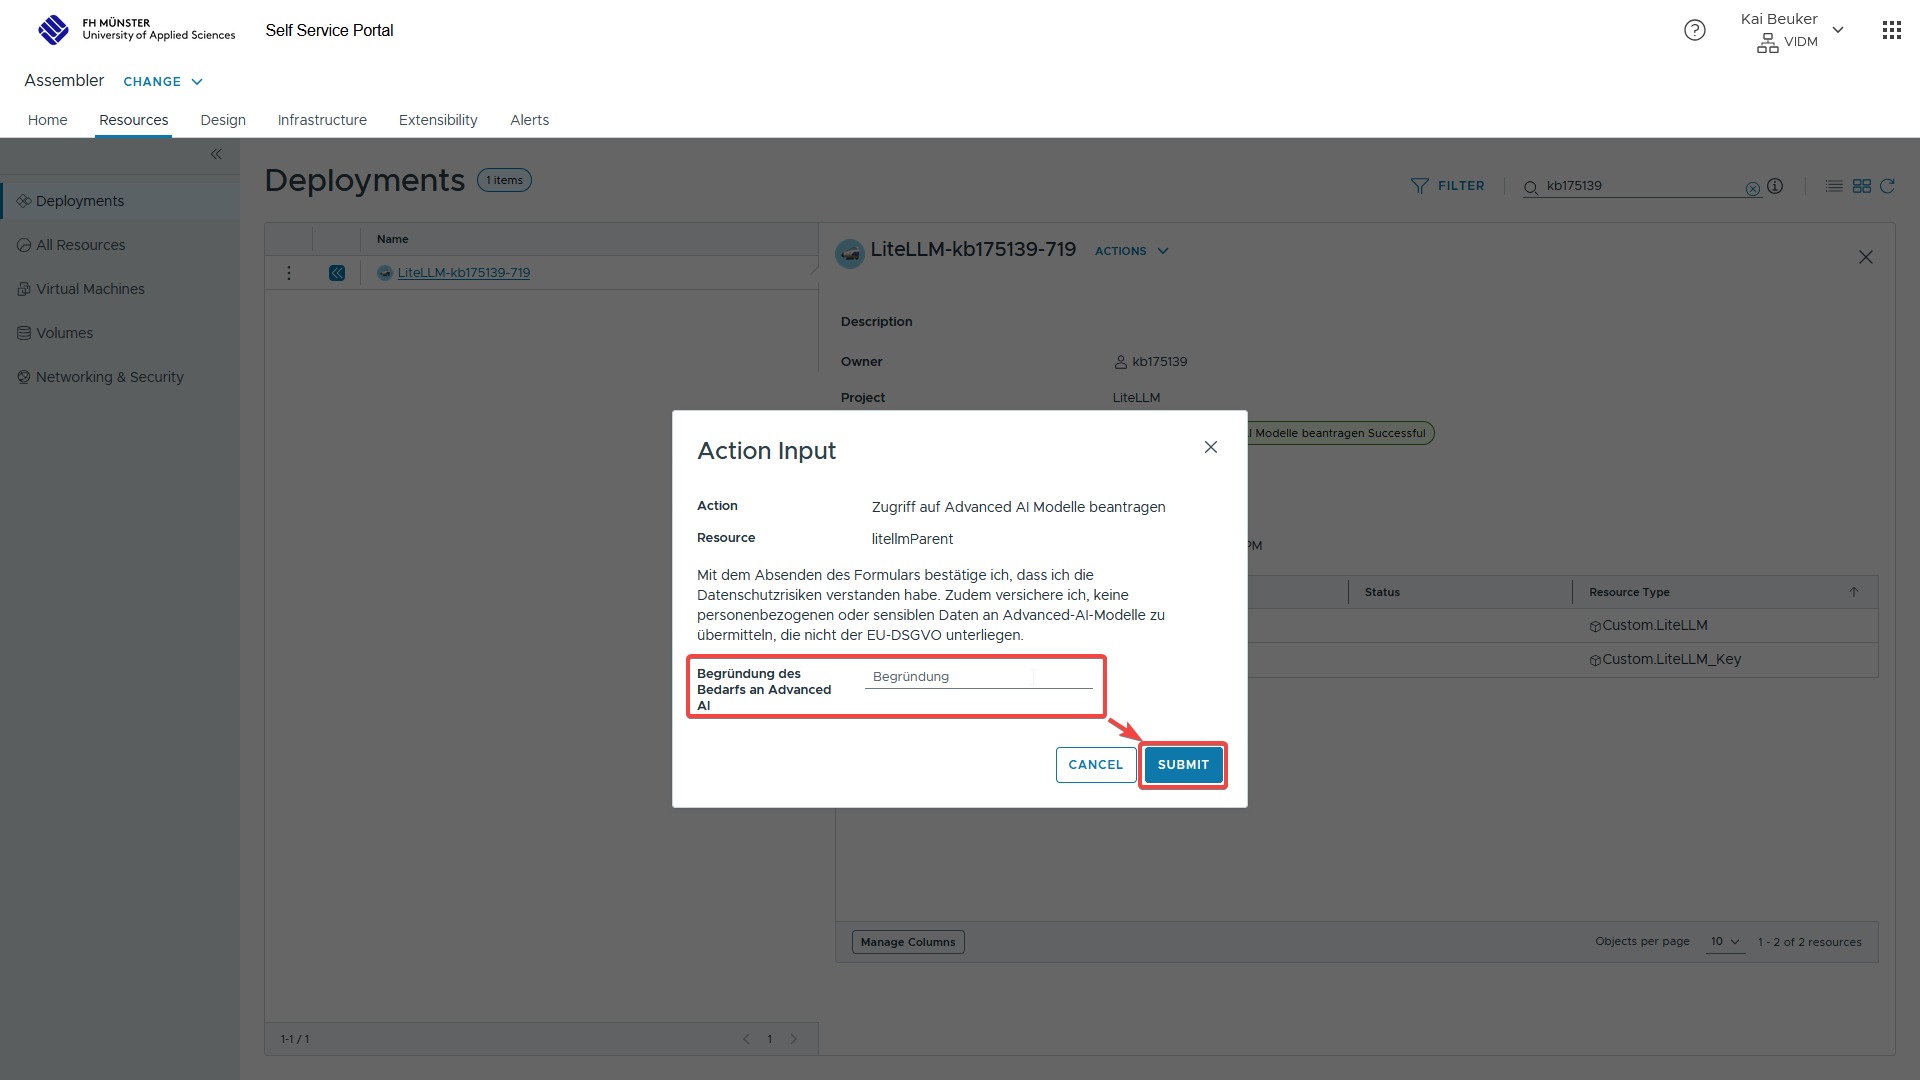
Bitte beachten Sie unbedingt:
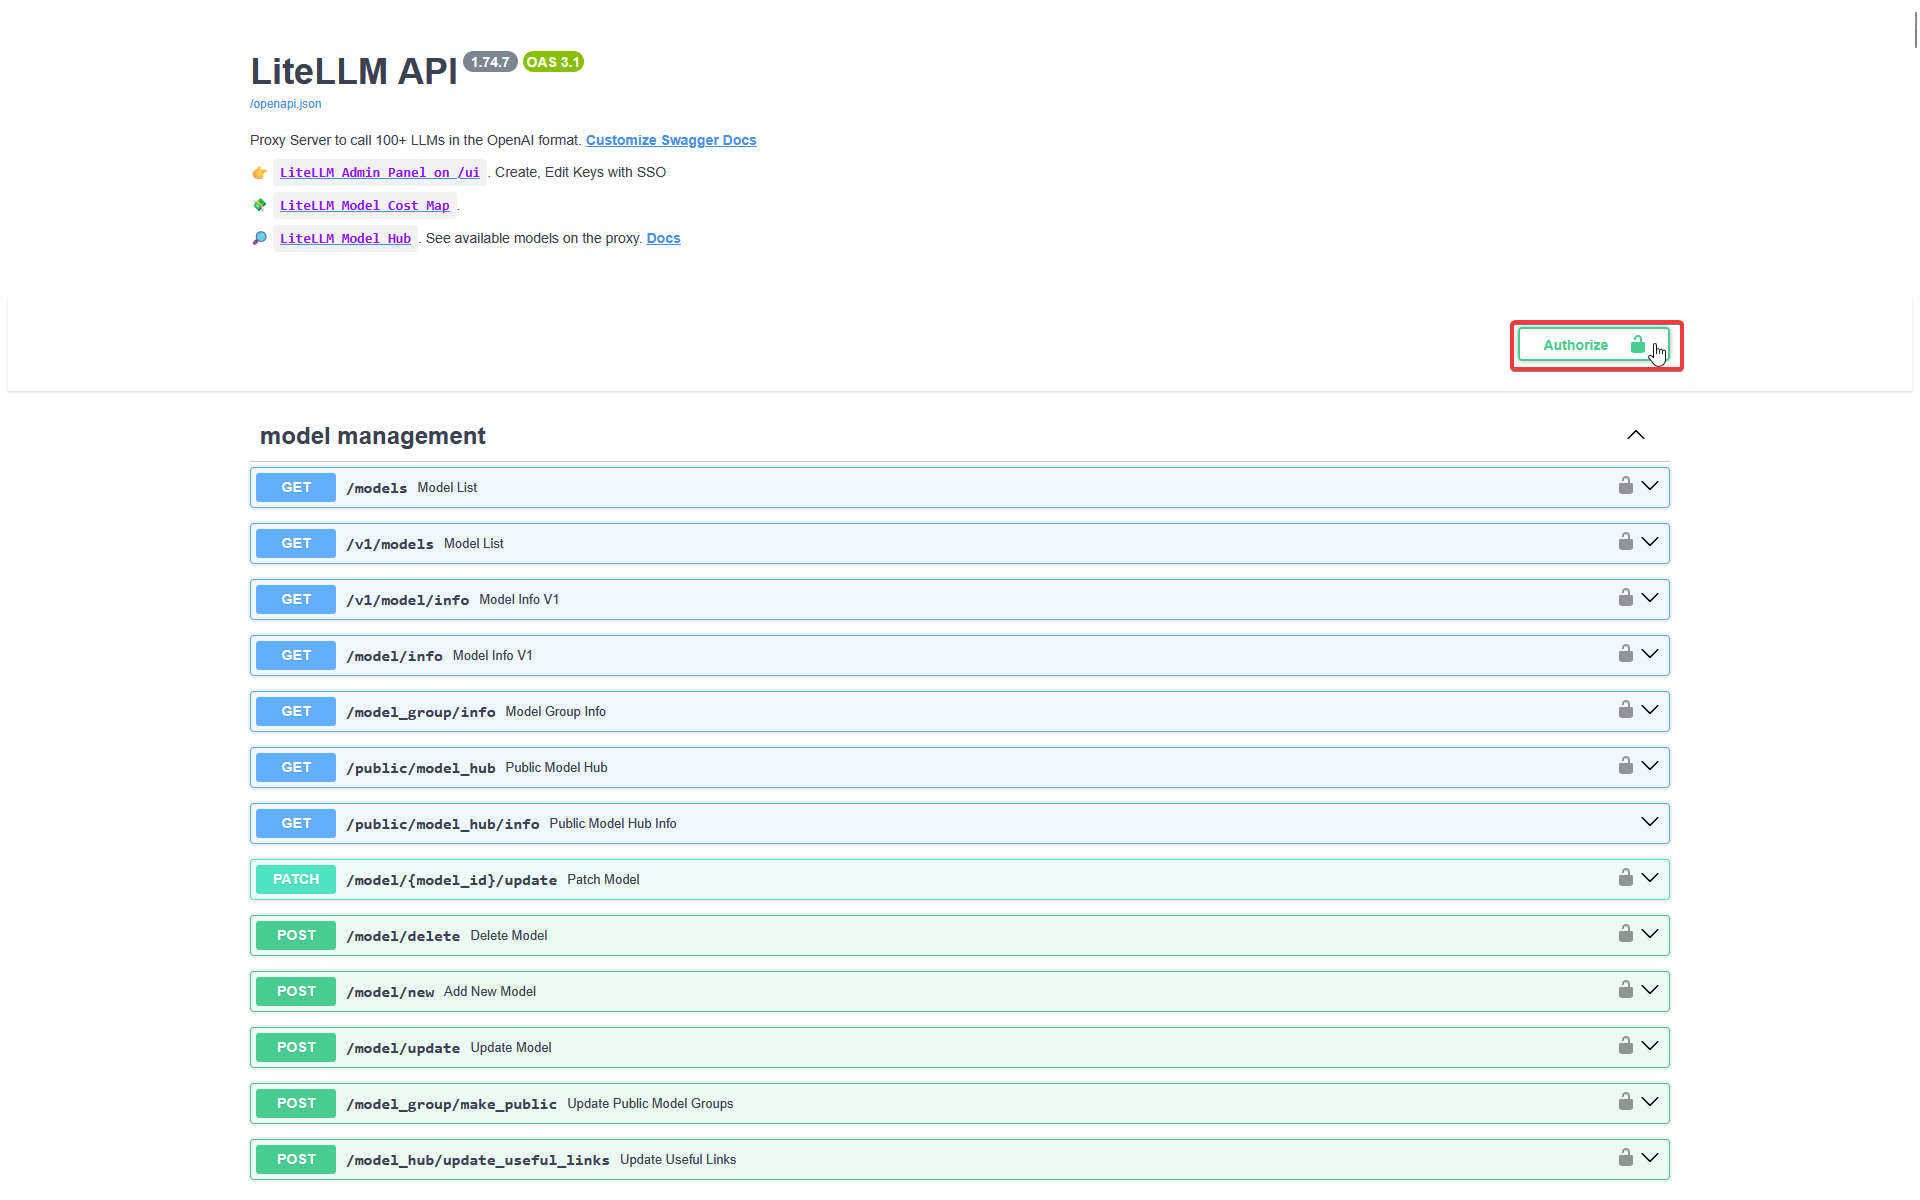
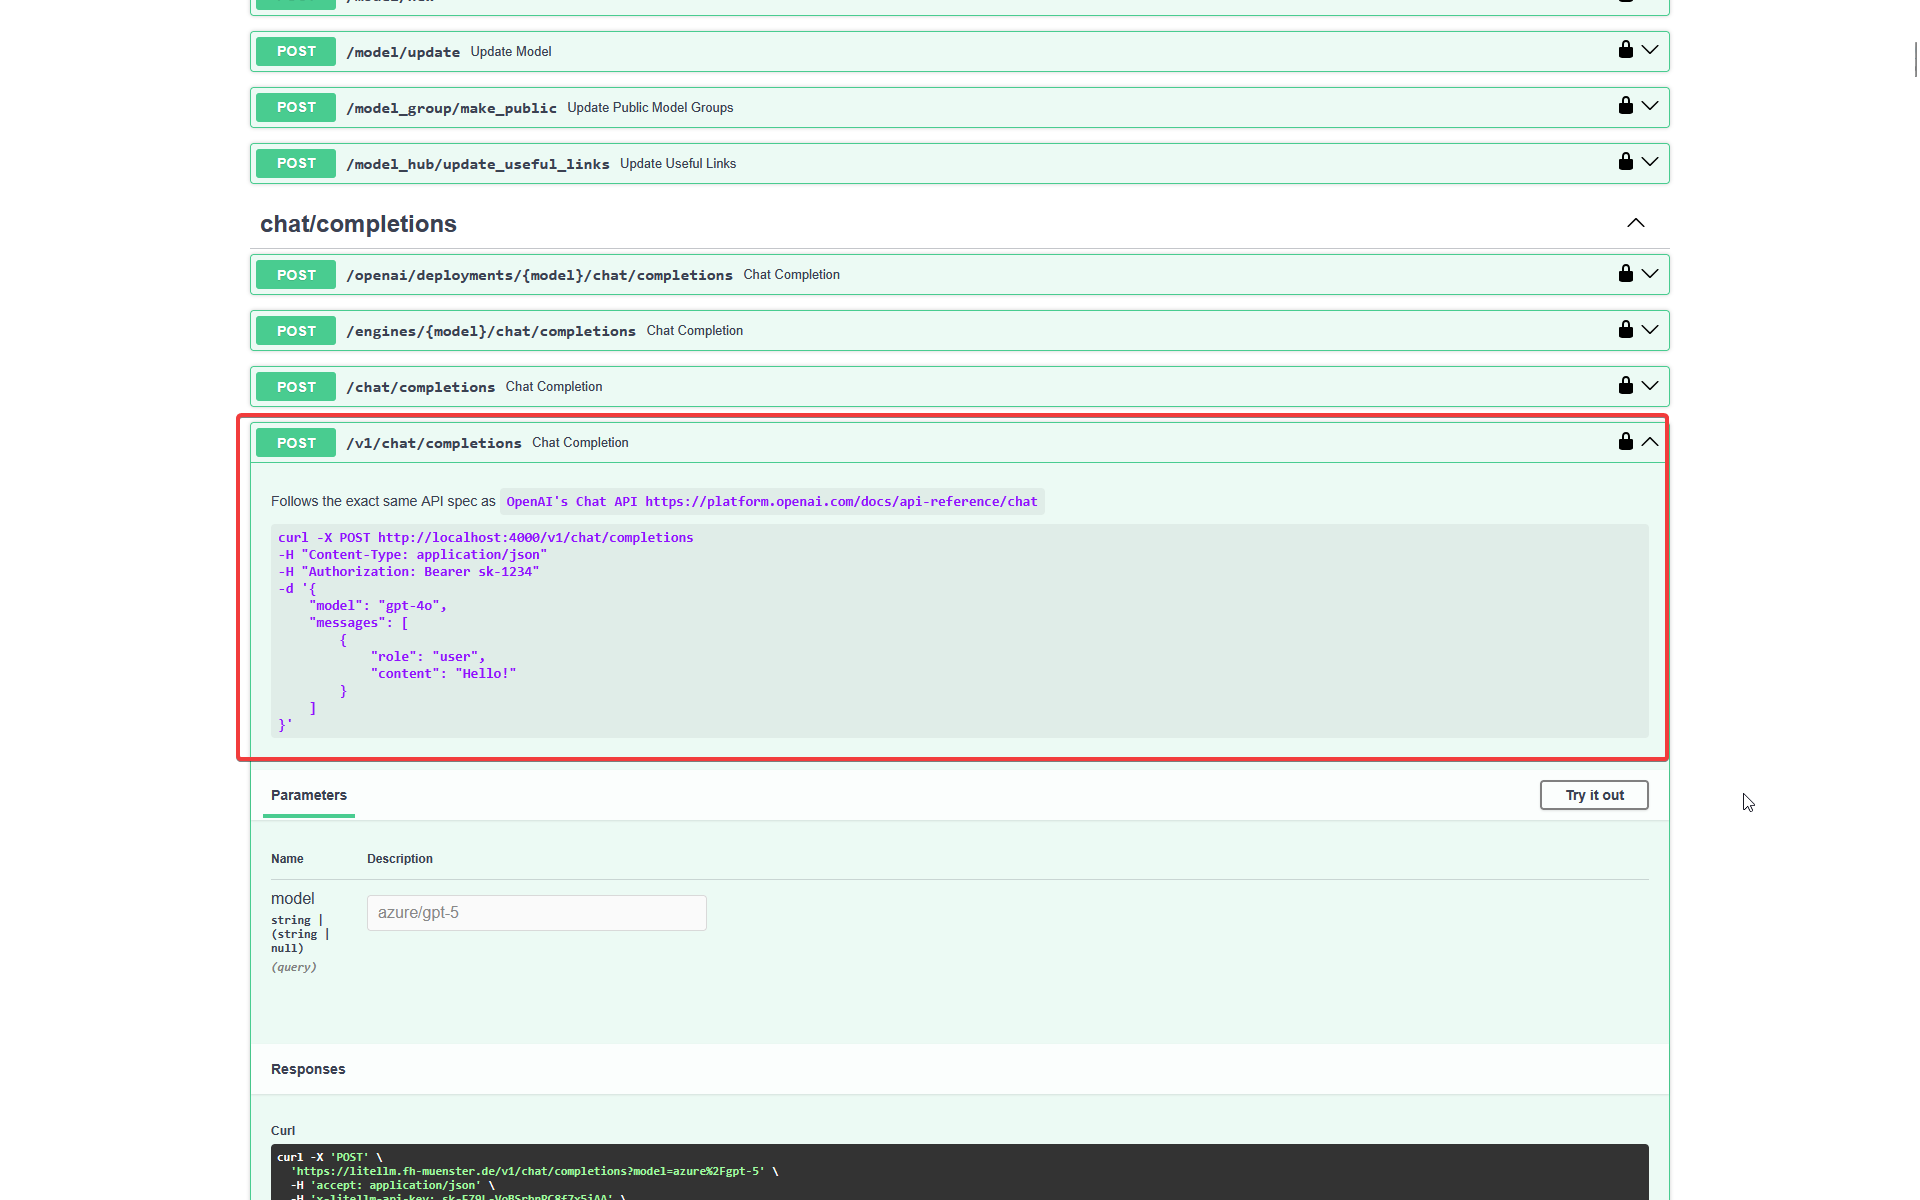
Hier ein beispielhafter API Call:
curl https://litellm.fh-muenster.de/v1/chat/completions -H "Authorization: Bearer sk-..." -H "Content-Type: application/json" -d '{ "model": "azure/gpt-5", "messages": [ {"role": "user", "content": "Was ist der Sinn des Lebens?"} ] }' |
Beispiel für Audio-Transkriptionsmodelle:
curl --location 'https://litellm.fh-muenster.de/v1/audio/transcriptions' --header 'Authorization: Bearer sk-...' --form 'file=@"/home/FHID/filename.mp3"' --form 'model="NOT-EU-azure/gpt-4o-transcribe"' |
Videoerstellung starten:
curl --location 'https://litellm.fh-muenster.de/v1/videos' -H 'Content-Type: application/json' -H 'Authorization: Bearer sk-...' -d '{"model": "NOT-EU-vertex/veo-3.1-generate-preview", "prompt": "A beautiful sunset over the ocean"}' |
In der response gibt es eine Video ID. Die wird benötigt. Beispiel:
"id":"video_bGl0ZWxsbTpjdXN0b21fbGxtX3Byb3ZpZGVyOnZlcnRleF9haTttb2RlbF9pZDp2ZW8tMy4xLWdlbmVyYXRlLXByZXZpZXc7dmlkZW9faWQ6cHJvamVjdHMvZmhtdWVuc3Rlci1raS9sb2NhdGlvbnMvdXMtY2VudHJhbDEvcHVibGlzaGVycy9nb29nbGUvbW9kZWxzL3Zlby0zLjEtZ2VuZXJhdGUtcHJldmlldy9vcGVyYXRpb25zLzIzNzIxMWRjLTViNmEtNDEzYS2efdgegreghxYWFmYzIwZQ=="
Status überprüfen:
curl -k https://litellm.fh-muenster.de/v1/videos/video_bGl0ZWxsbTpjdX... -H "Authorization: Bearer sk-..." |
Video herunterladen:
curl -k "https://litellm.fh-muenster.de/v1/videos/video_bGl0ZWxsbTpjdX.../content" -H "Authorization: Bearer sk-..." --output sunset.mp4 |
Video mit Referenzbild geht nur mit Python script:
import time
import requests

# FH Münster LiteLLM Server
API_BASE = "https://litellm.fh-muenster.de"
API_KEY = "sk-..." # Hier Ihren LiteLLM API Schlüssel einfügen

def check_for_budget_error(response):
    """Prüft ob das Budget überschritten wurde"""
    try:
        result = response.json()
        error = result.get("error", {})
        if error.get("type") == "budget_exceeded" or "ExceededBudget" in error.get("message", ""):
            return True, error.get("message")
    except:
        pass
    return False, None

def generate_and_download_video(prompt, reference_image_path=None):
    headers = {
        "Authorization": f"Bearer {API_KEY}"
    }

    # Step 1: Generate video
    print("Starting video generation...")

    if reference_image_path:
        with open(reference_image_path, "rb") as f:
            files = {
                "input_reference": f
            }
            data = {
                "model": "NOT-EU-vertex/veo-3.1-generate-preview", # Modell auswählen
                "prompt": prompt
            }
            response = requests.post(
                f"{API_BASE}/v1/videos",
                headers=headers,
                data=data,
                files=files
            )
    else:
        data = {
            "model": "NOT-EU-vertex/veo-3.1-generate-preview", # Modell ohne Referenzbild
            "prompt": prompt
        }
        response = requests.post(
            f"{API_BASE}/v1/videos",
            headers=headers,
            data=data
        )

    print(f"Response status: {response.status_code}")

    # Check for budget exceeded
    budget_exceeded, error_msg = check_for_budget_error(response)
    if budget_exceeded:
        print("\n" + "="*50)
        print("FEHLER: BUDGET ÜBERSCHRITTEN!")
        print(error_msg)
        print("="*50)
        return None

    print(f"Response: {response.text}")

    result = response.json()
    video_id = result.get("id")

    if not video_id:
        print("Error: No video ID received")
        return None

    print(f"Video ID: {video_id}")

    # Step 2: Poll for completion
    print("Waiting for video processing...")
    max_attempts = 60
    attempt = 0

    while attempt < max_attempts:
        try:
            # Check status
            status_response = requests.get(
                f"{API_BASE}/v1/videos/{video_id}",
                headers=headers
            )

            # Check for budget exceeded
            budget_exceeded, error_msg = check_for_budget_error(status_response)
            if budget_exceeded:
                print("\n" + "="*50)
                print("FEHLER: BUDGET ÜBERSCHRITTEN!")
                print(error_msg)
                print("="*50)
                return None

            print(f"Status response: {status_response.status_code}")

            if status_response.status_code == 200:
                status_data = status_response.json()
                status = status_data.get("status")
                print(f"Attempt {attempt + 1}: Status = {status}")

                if status == "completed":
                    print("Video completed! Downloading...")

                    # Try to get content
                    content_response = requests.get(
                        f"{API_BASE}/v1/videos/{video_id}/content",
                        headers=headers
                    )

                    # Check for budget exceeded
                    budget_exceeded, error_msg = check_for_budget_error(content_response)
                    if budget_exceeded:
                        print("\n" + "="*50)
                        print("FEHLER: BUDGET ÜBERSCHRITTEN!")
                        print(error_msg)
                        print("="*50)
                        return None

                    if content_response.status_code == 200:
                        filename = f"video_{video_id[:20]}.mp4"
                        with open(filename, "wb") as f:
                            f.write(content_response.content)
                        print(f"Video saved: {filename}")
                        return filename
                    else:
                        print(f"Content download failed: {content_response.status_code}")
                        print(f"Response: {content_response.text}")

                        # Maybe the video URL is in the status response?
                        print(f"Full status data: {status_data}")
                        return None

                elif status == "failed":
                    print(f"Video generation failed: {status_data}")
                    return None

        except Exception as e:
            print(f"Attempt {attempt + 1}: Error - {e}")

        time.sleep(10)
        attempt += 1

    print("Timeout: Video generation took too long")
    return None


if __name__ == "__main__":
    result = generate_and_download_video(
        prompt="Make the dog in the reference image bark", # Geben Sie hier Ihren Prompt ein
        reference_image_path=r"C:\Users\mm123456\Veo\reference.png" # Pfad zum Referenzbild
    )

    if result:
        print(f"Success! Video saved as: {result}")
    else:
print("Failed to generate video") |
Weitere mögliche Parameter: https://docs.litellm.ai/docs/providers/vertex_ai/videos#video-generation-parameters
Hier zu beachten:
Da wir vermehrt Anfragen bekommen, wie man Claude Code via LiteLLM nutzen kann:
Es muss im Ordner .claude eine settings.json angelegt werden mit folgendem Inhalt.
{
  "env": {
    "ANTHROPIC_AUTH_TOKEN": "IHR-LITELLM-KEY",
    "ANTHROPIC_BASE_URL": "https://litellm.fh-muenster.de",
    "ANTHROPIC_DEFAULT_SONNET_MODEL": "vertex/claude-sonnet-5",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "vertex/claude-haiku-4-5",
    "ANTHROPIC_DEFAULT_OPUS_MODEL": "vertex/claude-opus-4-8"
  }
} |
OpenCode ist ein lokal integrierbarer KI-Code-Assistent, der als Alternative zu Claude Code dient und den Einsatz verschiedener Large Language Models ermöglicht.
OpenCode global installieren: npm install -g opencode-ai@latest
(Falls noch nicht vorhanden: Zuerst Node.js installieren)
Starten von OpenCode
Nutzung und Modus-Wechsel
Tipps für den effizienten Einsatz
Anhang
Aktuell befindet sich das Projekt noch in der Testphase - daher gibt es noch kein konkretes Budgetmodell. Während der Testphase bekommt jeder Nutzer ein 30$ Budget, welches sich jeweils am 1. April und am 1. Oktober zurücksetzt. Außerdem werden sämtliche Budgeterweiterungen zurückgesetzt.
Feedback, Änderungswünsche und feature requests gerne per Mail an: it-support@fh-muenster.de